ทดสอบ Qwen3.8 27B 7 ระดับ quantization ตั้งแต่ Q8_0 ถึง Q2_K_XL บน Radeon AI PRO R9700 ดูทั้งคุณภาพ (PPL, KLD, HellaSwag และโจทย์จริง 764 ข้อ) ความเร็ว และ VRAM
Tag: TPS
- เมื่อโมเดลถูกลดขนาดยังตอบคำถามได้เหมือนเดิมไหม: กรณีศึกษา Qwen3.8 27B ตั้งแต่ Q8 ถึง Q2
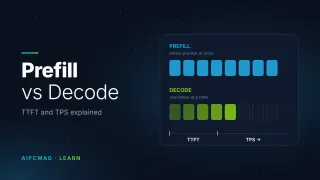
- Prefill vs Decode: TTFT และ TPS ต่างกันอย่างไร ความเร็วที่หลายคนสงสัย
อธิบายสองระยะการทำงานของ LLM คือ Prefill และ Decode พร้อมตัวชี้วัด TTFT และ TPS ว่าวัดอะไร ถูกจำกัดด้วยทรัพยากรใด และเหตุใดตัวเลขเดียวจึงบอกประสิทธิภาพไม่ครบ
- รายงานผลการทดสอบ: NVIDIA GeForce RTX 5060 Ti 16GB กับการรัน Local LLM บน Windows — ประชัน CUDA vs Vulkan บน Dense 12B และ MoE 26B
ผลการทดสอบเชิงลึกการ์ดจอ NVIDIA GeForce RTX 5060 Ti 16GB (สถาปัตยกรรม Blackwell) ด้วย PromptMark v0.4.0 เปรียบเทียบรันไทม์ CUDA vs Vulkan บน Gemma-4 12B และทดสอบขีดจำกัดหน่วยความจำบน Gemma-4 26B-A4B MoE ในภาวะ VRAM-Tight
- รายงานผลการทดสอบ: AMD Radeon RX 9070 XT 16GB กับการรัน Local LLM บน Windows — ประชัน ROCm vs Vulkan บน 8 โมเดล LLM พร้อมทดสอบขีดจำกัด Concurrency
ผลการทดสอบเชิงลึกการ์ดจอ AMD Radeon RX 9070 XT 16GB (สถาปัตยกรรม RDNA 4) ด้วย PromptMark v0.4.0 และ Concurrent Text Benchmark เปรียบเทียบรันไทม์ ROCm vs Vulkan ทั้งโมเดล MoE, Dense และฟอร์แมตควอนไทซ์ NVFP4 พร้อมวัดประสิทธิภาพการรองรับผู้ใช้พร้อมกัน 16 ผู้ใช้
- รายงานผลการทดสอบ: Intel Arc B580 Dual GPU (2x 12GB รวม 24GB VRAM) กับการรัน Local LLM บน Windows
ผลการทดสอบเชิงลึกการ์ดจอคู่ Intel Arc B580 24GB VRAM ด้วย PromptMark v0.4.0 เปรียบเทียบรันไทม์ SYCL vs Vulkan และสถาปัตยกรรม MoE vs Dense บน 8 โมเดล LLM ยอดนิยม
- รายงานผลการทดสอบ: Intel Arc B580 12GB กับการรัน Local LLM บน Windows (Vulkan vs SYCL)
ผลการทดสอบการ์ดจอ Intel Arc B580 12GB (สถาปัตยกรรม Xe2) ด้วย PromptMark เปรียบเทียบรันไทม์ Vulkan vs SYCL บน 5 รูปแบบโมเดล LLM พร้อมวิเคราะห์ Prefill, Decode และการสเกล Context 8K
- Decode (Token Generation)
ขั้นตอนสร้างคำตอบทีละ token หลังจาก Prefill เสร็จ วัดความเร็วเป็น tokens/s
- Throughput
ปริมาณงานที่ระบบทำได้ต่อหน่วยเวลา ในงาน LLM มักวัดเป็นจำนวน token ที่สร้างได้ต่อวินาที รวมทุกคำขอที่ทำพร้อมกัน
- TPS (Tokens per Second)
จำนวน token ที่โมเดลประมวลผลหรือสร้างได้ต่อวินาที ใช้บอกความเร็วของทั้ง Prefill และ Decode