Nous Research เปิดตัว Arete-27B โมเดลขนาด 27B ที่พัฒนาต่อยอดจาก Qwen3.8-27B ด้วยเทคนิค Post-training มุ่งลดพฤติกรรมการตอบตามกรอบแนวคิดของรัฐบาลจีน โดยใช้ข้อมูลฝึกเพิ่มเติมประมาณ 52.8 ล้าน Tokens และรักษา Agentic Capabilities ของโมเดลต้นฉบับไว้
AI Update
รวมข้อมูลความเคลื่อนไหวแวดวง Local AI
หัวข้อที่มีชื่อว่า “รวมข้อมูลความเคลื่อนไหวแวดวง Local AI”- Nous Research เปิดตัว Arete-27B โมเดลที่นำ Qwen3.8-27B มาปรับแต่งใหม่ เพื่อลดอคติทางการเมืองและเปลี่ยนกรอบการตอบสนองของ AI
- Strata 0.2.11 อัปเดต รองรับ Qwen3.8-Flash-Next รุ่นใหม่จาก Unsloth เพิ่มประสิทธิภาพ Multi-GPU และเร่งความเร็ว Prompt Processing
Strata 0.2.11 รองรับ Qwen3.8-Flash-Next จาก Unsloth Dynamic v3.1 ปรับปรุง Multi-GPU, NVIDIA CUDA, AMD Radeon และการจัดการ VRAM พร้อมแก้ไขปัญหาการบันทึก Chat และความเสถียร
- llama.cpp v0.9.0 อัปเดต เพิ่มการรองรับ FP8, ปรับปรุง KV Cache และเร่ง Prefill ของ Gemma 4
llama.cpp v0.9.0 เพิ่มการรองรับ FP8 E4M3, ปรับปรุง Unified KV Cache, เพิ่มโมเดลใหม่ 4 สถาปัตยกรรม และขยายความสามารถด้าน Local AI และ Multimodal
- MAI-Code-1.1-Flash: โมเดล MoE 137.9B บีบเหลือ 53 GB รันบน Windows ด้วย RTX Spark
Microsoft เผยวิธีบีบโมเดลเขียนโค้ด MAI-Code-1.1-Flash จากประมาณ 276 GB เหลือ 53.0 GiB พร้อม speculative decoding และผลวัดบน RTX Spark 128GB (ผลวัดของ Microsoft ไม่ใช่ผลทดสอบของเรา)
- Qwen3.8-Flash-Next GGUF จาก Unsloth ใช้ Dynamic V3.1 ลดขนาดโมเดล 125B ให้รันบนเครื่องที่มีแรมจำกัดได้ง่ายขึ้น
Unsloth ปล่อย GGUF ของ Qwen3.8-Flash-Next ด้วยอัลกอริทึม Dynamic V3.1 (preview) พร้อมตัวเลือก MTP และ engram แบบเลือกความละเอียดได้ บทความนี้สรุปว่าใครควรสนใจ และตัวเลขไหนเป็นคำอ้างของผู้ผลิต
- vLLM 0.33.0 อัปเดต เพิ่มประสิทธิภาพ รองรับ Qwen3.8-Flash-Next และปรับปรุง Multi-GPU บน CUDA และ ROCm
vLLM 0.33.0 อัปเดต PyTorch 2.14 เพิ่มการรองรับโมเดล AI รุ่นใหม่ ปรับปรุง Speculative Decoding, KV Cache และเพิ่มประสิทธิภาพ Inference บน NVIDIA และ AMD
- llama.cpp v0.8.0 อัปเดต เพิ่มโมเดลใหม่ ปรับปรุง MoE และ GPU Backend พร้อมรองรับ Realtime API
llama.cpp v0.8.0 เพิ่มการรองรับโมเดล AI รุ่นใหม่ ปรับปรุง MoE และ Sparse Attention ขยายความสามารถ GPU Backend พร้อมเพิ่ม Realtime API, TTS และฟีเจอร์สำหรับ AI Agent
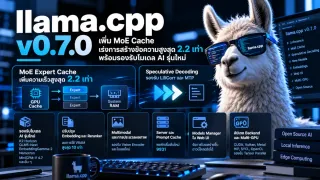
- llama.cpp v0.7.0 อัปเดตครั้งใหญ่ เพิ่ม MoE Cache เร่งการสร้างข้อความสูงสุด 2.2 เท่า พร้อมรองรับโมเดล AI รุ่นใหม่
โครงการ llama.cpp เปิดตัวเวอร์ชัน 0.7.0 เมื่อวันที่ 15 ตุลาคม 2026 โดยเน้นปรับปรุงประสิทธิภาพการรัน LLM บนเครื่องคอมพิวเตอร์ส่วนตัว เพิ่มเทคนิคเร่งการสร้างข้อความ รองรับโมเดลรุ่นใหม่ และปรับปรุงระบบ Server สำหรับการให้บริการ AI ผ่าน API
- NVIDIA เปิดตัว Nemotron 3.5 Super VL โมเดลมัลติโมดัลสำหรับ AI Agent ระดับองค์กร
NVIDIA เปิดตัว Nemotron 3.5 Super VL มัลติโมดัลแบบเปิดและปรับแต่งได้ ที่ออกแบบมาเพื่อสร้าง AI Agent เฉพาะทางสำหรับงานองค์กร
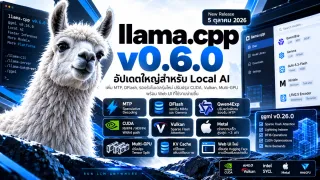
- llama.cpp v0.6.0 อัปเดตใหญ่สำหรับ Local AI ปรับปรุง MTP, DFlash, Vulkan รองรับโมเดลรุ่นใหม่ และเพิ่ม API สำหรับ Decision Models
llama.cpp v0.6.0 อัปเดต เวอร์ชันนี้มาพร้อมการปรับปรุงหลายด้าน ทั้ง MTP และ DFlash, Qwen4Exp, CUDA สำหรับ NVFP4/MXFP4, Vulkan Sparse Flash Attention, KV Cache และ Multi-GPU รวมถึง Web UI ใหม่
- NVIDIA DGX Spark 64GB: เปิดทางเลือกใหม่ให้สาย Local AI รันโมเดลใหญ่ได้เต็มเครื่อง ไม่ต้องง้อ Cloud
NVIDIA ประกาศเปิดจำหน่าย NVIDIA DGX Spark รุ่นความจำ 64GB อย่างเป็นทางการ เริ่ม 23 ตุลาคม 2026
- Alibaba เปิดตัว Qwen-Image-2.1 โมเดลสร้างภาพขนาดเพียง 7B ที่เก่งเกินตัว สร้างภาพได้หลากหลายสไตล์
Qwen-Image-2.1 ถูกออกแบบให้สร้างสมดุลระหว่างคุณภาพของภาพ ความเร็วในการประมวลผล และต้นทุนการใช้งาน โดยเปิดซอร์สโมเดลผ่าน GitHub, Hugging Face และ ModelScope แล้ว
- llama.cpp v0.5.0 อัปเดตใหญ่ ปรับ CUDA, Vulkan, SYCL และ Local AI Server ให้รองรับโมเดลยุคใหม่ดีขึ้น
สำหรับผู้ใช้ Local AI การอัปเดต llama.cpp v0.5.0 ครั้งนี้น่าสนใจเป็นพิเศษ เพราะมีการปรับปรุงทั้ง CUDA, HIP/ROCm, Vulkan, SYCL และ Metal พร้อมกัน
- DeepSeek เปิดตัว V4-Flash-Vision-Exp เพิ่มความสามารถ “การมองเห็น” ให้ AI Agent
DeepSeek-V4-Flash-Vision-Exp โมเดล AI แบบมัลติโมดัลรุ่นทดลองบนแพลตฟอร์ม DeepSeek API โดยเพิ่มความสามารถในการทำความเข้าใจภาพและภาพหน้าจอ
- DeepSeek เปิดตัว DeepSeek Harness ระบบ AI Agent แบบ Open Source ชูแนวคิด ทุกอย่างคือ Plugin ปูทางสู่ Agent ที่ปรับแต่งได้เอง
DeepSeek กำลังขยับจากการเป็นบริษัทที่พัฒนาโมเดลภาษา ไปสู่การสร้าง โครงสร้างพื้นฐานสำหรับ AI Agent ด้วยการเปิดตัว DeepSee…
- Alibaba เปิดตัว Qwen3.8-27B เน้นงาน Coding, Agent และ Multimodal
Alibaba Cloud เปิดโมเดล Qwen3.8-27B ที่เหมาะกับผู้ใช้งานพีซีทั่วไปให้ดาวน์โหลดและนำไปใช้งานได้แล้ว โดยโมเดลรุ่นนี้อยู่ใน…
- Meta เปิดตัว Muse Glimmer โมเดล AI Agent 30B แบบ Open Weights รันบน PC ด้วย GPU ใบเดียวได้
Meta เปิดตัว Muse Glimmer โมเดล AI แบบ Open Weights ขนาด 30 พันล้านพารามิเตอร์ ที่ออกแบบมาโดยเฉพาะสำหรับการทำงานแบบ AI A…
- NVIDIA เปิดตัว Nemotron 3.5 Lightning โมเดลขนาด 30B เน้นเร็วและประหยัด พร้อม NeMo Switchyard ระบบเลือกโมเดลอัตโนมัติสำหรับ AI Agent
NVIDIA เปิดตัว Nemotron 3.5 Lightning โมเดลภาษาแบบเปิดสำหรับงาน Agentic AI และ NeMo Switchyard ไลบรารีโอเพนซอร์สสำหรับจั…
- Unsloth ประกาศรองรับ GPU ของ AMD อย่างเป็นทางการ ผู้ใช้ Radeon กำลังก้าวจากการรัน Local LLM สู่การสร้างโมเดลบนเครื่องตัวเอง
Unsloth ประกาศรองรับ GPU ของ AMD ทั้งบน Windows, WSL และ Linux ครอบคลุมตั้งแต่การรันโมเดล การ Fine-tune ไปจนถึงการ Expor…
- LM Studio Bionic ก้าวใหม่จากโปรแกรมรัน Local AI สู่ AI Agent ที่ยังคงเน้นการทำงานบนเครื่องของเราเหมือนเดิม
จากเดิมที่หลายคนรู้จัก LM Studio ในฐานะโปรแกรมสำหรับดาวน์โหลดและรันโมเดล AI บนเครื่องพีซี ล่าสุดทีมพัฒนาได้ประกาศเปิดตัว…