Prefill vs Decode: TTFT และ TPS ต่างกันอย่างไร ความเร็วที่หลายคนสงสัย
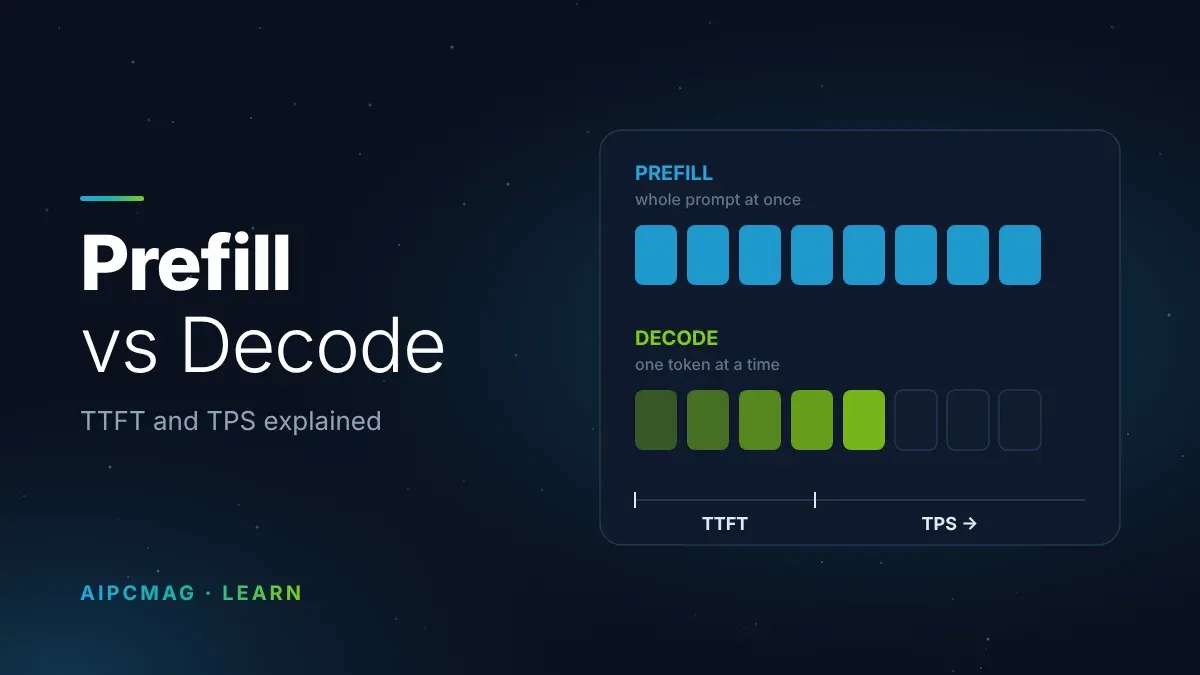
เวลาพูดถึงความเร็วของ LLM เรา มักได้ยินตัวเลขตัวเดียว เช่น “ได้ 60 tok/s” แต่ในความเป็นจริง โมเดลทำงานสองระยะที่ใช้ทรัพยากรต่างกันโดยสิ้นเชิง การแยกวัดสองระยะนี้ทำให้คุณเข้าใจได้ว่าเครื่องของคุณติดที่ตรงไหน และจะปรับให้เร็วขึ้นได้อย่างไร
สองระยะของการทำงาน
หัวข้อที่มีชื่อว่า “สองระยะของการทำงาน”เมื่อคุณส่ง prompt เข้าโมเดล มันประมวลผลเป็นสองช่วงต่อเนื่องกัน
- Prefill คือการประมวลผลโทเคนทั้งหมดของ prompt พร้อมกันในครั้งเดียว คำนวณ attention ของโทเคนที่มีอยู่ทั้งหมดเพื่อสร้าง KV cache เริ่มต้น ระยะนี้ใช้พลังประมวลผล (compute) สูง
- Decode คือการสร้างโทเคนตอบกลับ ทีละตัวตามลำดับ โดยใช้ KV cache ที่มีอยู่ ไม่ต้องคำนวณ prompt ซ้ำ ระยะนี้ถูกจำกัดด้วย แบนด์วิดท์หน่วยความจำ มากกว่าพลังประมวลผล
การทำงานแบบขนานในระยะ prefill คือหัวใจของ attention ในสถาปัตยกรรม Transformer ซึ่งประมวลผลทุกตำแหน่งพร้อมกันได้
TTFT และ TPS คืออะไร
หัวข้อที่มีชื่อว่า “TTFT และ TPS คืออะไร”| ตัวชี้วัด | ความหมาย | ได้รับอิทธิพลจาก |
|---|---|---|
| TTFT (Time To First Token) | เวลาตั้งแต่ส่ง prompt จนได้โทเคนแรก | ความยาว prompt, ความเร็ว prefill, การเข้าคิว |
| TPS (Tokens Per Second) | จำนวนโทเคนที่สร้างต่อวินาทีในระยะ decode | แบนด์วิดท์หน่วยความจำ, ขนาดโมเดล, batch |
จุดสำคัญคือ TTFT กับ TPS (tok/s) วัดคนละระยะ คุณจึงอาจเจอสถานการณ์ที่มี TPS สูงแต่ TTFT แย่ หรือกลับกัน
ทำไมสองระยะใช้ทรัพยากรต่างกัน
หัวข้อที่มีชื่อว่า “ทำไมสองระยะใช้ทรัพยากรต่างกัน”Prefill เป็นงานที่ compute-bound: GPU ต้องคำนวณเมทริกซ์ขนาดใหญ่พร้อมกัน จึงได้ประโยชน์จากจำนวนคอร์และเทคนิคเร่งความเร็วอย่าง Flash Attention ซึ่งลดการอ่าน-เขียนหน่วยความจำระหว่างคำนวณ
Decode เป็นงานที่ memory-bandwidth-bound: ทุกโทเคนใหม่ต้องอ่านน้ำหนักโมเดลทั้งหมดกลับมาใช้ใหม่ งานส่วนใหญ่จึงเป็นการขนข้อมูล ไม่ใช่การคำนวณ นี่คือเหตุผลว่าทำไมการ์ดที่มีแบนด์วิดท์สูงกว่าจึงได้ TPS ดีกว่า แม้พลังประมวลผลใกล้กัน
ผลของการทำ Batch
หัวข้อที่มีชื่อว่า “ผลของการทำ Batch”เมื่อประมวลผลหลายคำขอพร้อมกัน:
- Prefill ยิ่งทำพร้อมกันยิ่งใช้ compute มาก และอาจทำให้ TTFT ของแต่ละคำขอนานขึ้น
- Decode ได้ประโยชน์ เพราะอ่านน้ำหนักครั้งเดียวแล้วใช้กับหลายคำขอ แต่ละคำขอจึงได้ TPS รวมสูงขึ้น
นี่คือสมดุลที่ระบบให้บริการต้องจูน ถ้าคุณรันโมเดลคนเดียว การทำ batch ไม่จำเป็น แต่ถ้าให้บริการหลายผู้ใช้ ต้องตัดสินใจว่าจะยอมแลก TTFT กับ throughput
เอาไปใช้จริง
หัวข้อที่มีชื่อว่า “เอาไปใช้จริง”- แยกวัดสองตัวเลขเสมอ อย่าดู TPS อย่างเดียว เพราะมันไม่บอกว่าเริ่มตอบเร็วแค่ไหน
- ถ้า TTFT สูง มักมาจาก prompt ยาว ลองย่อ prompt หรือเพิ่มพลังประมวลผล
- ถ้า TPS ต่ำ มักติดแบนด์วิดท์ ลองใช้ Quantization ที่เล็กกว่า หรือเลือกการ์ดที่แรงกว่า
- วัดด้วยเงื่อนไขเดียวกัน prompt ความยาวใกล้เคียงกันจึงเปรียบเทียบได้อย่างยุติธรรม
ตัวเลขทั้งสองนี้ผูกกับ KV cache ที่อธิบายไว้ใน Context Window และ KV Cache และกับหน่วยความจำที่โมเดลกิน ซึ่งอ่านต่อได้ใน VRAM Budget และ GPU Offload