Strata 0.2.11 รองรับ Qwen3.8-Flash-Next จาก Unsloth Dynamic v3.1 ปรับปรุง Multi-GPU, NVIDIA CUDA, AMD Radeon และการจัดการ VRAM พร้อมแก้ไขปัญหาการบันทึก Chat และความเสถียร
Tag: GGUF
- Strata 0.2.11 อัปเดต รองรับ Qwen3.8-Flash-Next รุ่นใหม่จาก Unsloth เพิ่มประสิทธิภาพ Multi-GPU และเร่งความเร็ว Prompt Processing
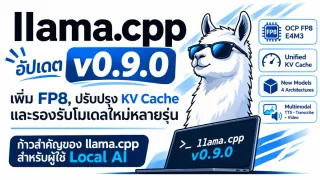
- llama.cpp v0.9.0 อัปเดต เพิ่มการรองรับ FP8, ปรับปรุง KV Cache และเร่ง Prefill ของ Gemma 4
llama.cpp v0.9.0 เพิ่มการรองรับ FP8 E4M3, ปรับปรุง Unified KV Cache, เพิ่มโมเดลใหม่ 4 สถาปัตยกรรม และขยายความสามารถด้าน Local AI และ Multimodal
- Qwen3.8-Flash-Next GGUF จาก Unsloth ใช้ Dynamic V3.1 ลดขนาดโมเดล 125B ให้รันบนเครื่องที่มีแรมจำกัดได้ง่ายขึ้น
Unsloth ปล่อย GGUF ของ Qwen3.8-Flash-Next ด้วยอัลกอริทึม Dynamic V3.1 (preview) พร้อมตัวเลือก MTP และ engram แบบเลือกความละเอียดได้ บทความนี้สรุปว่าใครควรสนใจ และตัวเลขไหนเป็นคำอ้างของผู้ผลิต
- รันโมเดล 125B บนการ์ด Radeon AI PRO R9700 สองใบ (Qwen3.8-Flash-Next)
ทดสอบโมเดล MoE ขนาด 75.8 GB ที่การ์ดใบเดียวรับไม่ไหว บน Radeon AI PRO R9700 สองใบ ด้วย ROCm และ Vulkan ทั้งบริบทสั้นและบริบทยาวถึง 128K พร้อมผลทดลอง MTP
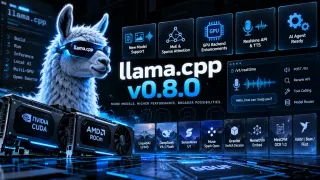
- llama.cpp v0.8.0 อัปเดต เพิ่มโมเดลใหม่ ปรับปรุง MoE และ GPU Backend พร้อมรองรับ Realtime API
llama.cpp v0.8.0 เพิ่มการรองรับโมเดล AI รุ่นใหม่ ปรับปรุง MoE และ Sparse Attention ขยายความสามารถ GPU Backend พร้อมเพิ่ม Realtime API, TTS และฟีเจอร์สำหรับ AI Agent
- เมื่อโมเดลถูกลดขนาดยังตอบคำถามได้เหมือนเดิมไหม: กรณีศึกษา Qwen3.8 27B ตั้งแต่ Q8 ถึง Q2
ทดสอบ Qwen3.8 27B 7 ระดับ quantization ตั้งแต่ Q8_0 ถึง Q2_K_XL บน Radeon AI PRO R9700 ดูทั้งคุณภาพ (PPL, KLD, HellaSwag และโจทย์จริง 764 ข้อ) ความเร็ว และ VRAM
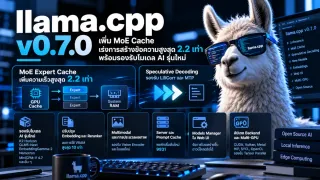
- llama.cpp v0.7.0 อัปเดตครั้งใหญ่ เพิ่ม MoE Cache เร่งการสร้างข้อความสูงสุด 2.2 เท่า พร้อมรองรับโมเดล AI รุ่นใหม่
โครงการ llama.cpp เปิดตัวเวอร์ชัน 0.7.0 เมื่อวันที่ 15 ตุลาคม 2026 โดยเน้นปรับปรุงประสิทธิภาพการรัน LLM บนเครื่องคอมพิวเตอร์ส่วนตัว เพิ่มเทคนิคเร่งการสร้างข้อความ รองรับโมเดลรุ่นใหม่ และปรับปรุงระบบ Server สำหรับการให้บริการ AI ผ่าน API
- ถอดรหัสโมเดล Q4_K_M, Q3_K_XL หมายถึงอะไร
อธิบาย Quantization ของโมเดล Local AI ผ่านชื่อ GGUF อย่าง Q4_K_M, Q5_K_M และ Q8_0 ว่าแต่ละส่วนหมายถึงอะไร พร้อมแนวคิด bpw ที่ใช้คำนวณขนาดและหน่วยความจำ
- GLM-5.2-GGUF มาแล้ว: โมเดลเปิด 744B ที่รันแบบ Local ได้ แต่ต้องการหน่วยความจำระดับ 200GB ขึ้นไป
Unsloth ปล่อย GLM-5.2-GGUF สำหรับรันโมเดล GLM-5.2 แบบ Local AI ด้วย quantization ระดับ 1-bit ถึง 8-bit แต่ยังต้องใช้ RAM+VRAM หลัก 200GB ขึ้นไป ไม่ใช่โมเดลสำหรับคอมพิวเตอร์ทั่วไป
- GGUF
รูปแบบไฟล์สำหรับเก็บโมเดล ที่โปรแกรมอย่าง llama.cpp, LM Studio และ Ollama อ่านและรันได้ โดยรวม weights และข้อมูลประกอบ (metadata) ไว้ด้วยกัน
- Quantization
การลดความละเอียดของตัวเลข weights ในโมเดล (เช่น จาก 16-bit เหลือ 4-bit) เพื่อให้ไฟล์เล็กลงและใช้ RAM/VRAM น้อยลง โดยแลกกับคุณภาพที่อาจลดลง