รันโมเดล 125B บนการ์ด Radeon AI PRO R9700 สองใบ (Qwen3.8-Flash-Next)
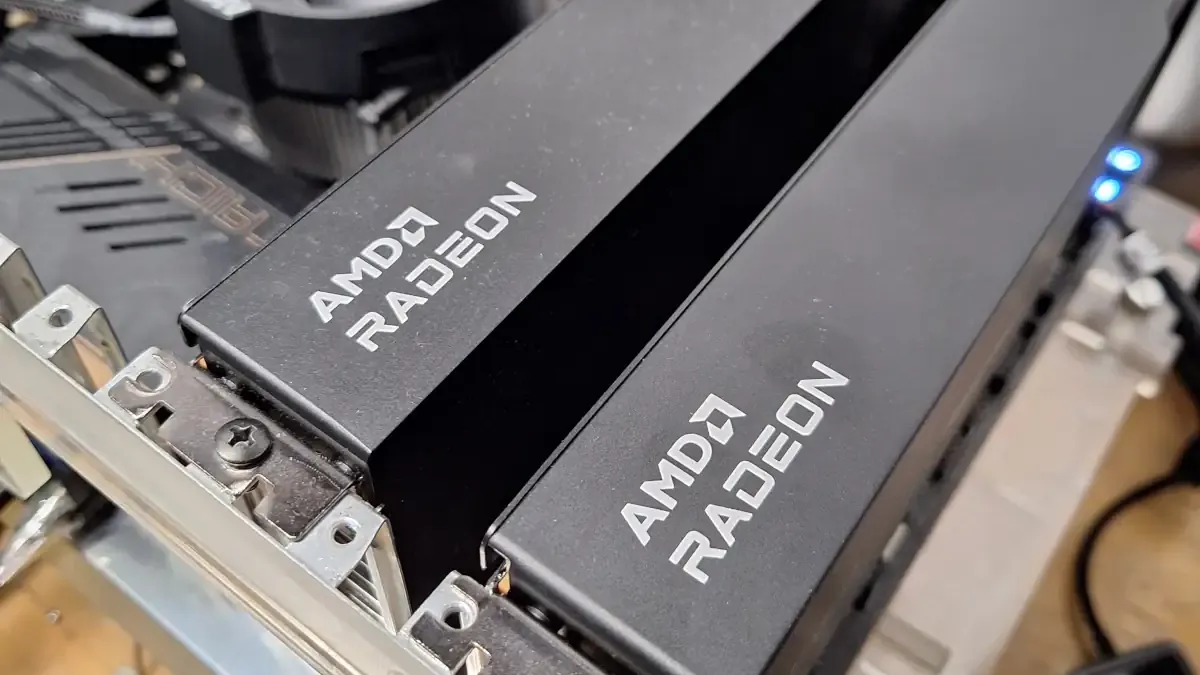
บทความนี้เสนอการทดสอบประสิทธิภาพของการ์ดจอ AMD Radeon AI Pro R9700 32GB จำนวนสองใบ เพื่อรันโมเดล Qwen3.8 Flash Next ที่มีพารามิเตอร์มากถึง 125B เพื่อตอบคำถามและข้อสงสัยว่าการ์ดจอสองตัวที่รวม VRAM 32GB + 32GB จะเพียงพอต่อการรันโมเดลขนาดใหญ่ระดับ 125B ได้หรือไม่ แม้ว่าโมเดลนี้จะเป็นแบบ MoE ที่ในการสร้างโทเคนแต่ละครั้งจะใช้น้ำหนักโมเดลเพียง 6B (6 พันล้านพารามิเตอร์) เท่านั้น
แต่ก็ต้องบอกไว้ก่อนครับว่าโมเดลที่เราเลือกมารันนี้เป็นรุ่น Qwen3.8-Flash-Next (GSQ-RCO GGUF, IQ3_XXS) ที่มีการลดขนาดมาแล้ว เพราะ Qwen3.8 Flash Next ตัวเต็มเฉพาะไฟล์โมเดลก็มีขนาดใหญ่ราว ~335GB และถ้ารันจริงที่ต้องเผื่อ Context และ KV Cache ด้วยก็ต้องมี RAM ในระดับ 400GB+ ซึ่ง AI PC สเปคสูง ก็ยังยากที่จะรันและใช้งานจริงได้
สรุปสำหรับคนรีบ
หัวข้อที่มีชื่อว่า “สรุปสำหรับคนรีบ”- รันได้จริงและเสถียร ทั้ง ROCm และ Vulkan ทุกรันให้ผลถูกต้อง (smallctx 35/35 และ longctx 30/30 ต่อแบ็กเอนด์) ไม่มีรันล้มเหลว
- ต้องใช้สองใบ ส่วนน้ำหนักที่ต้องอยู่ใน VRAM คือ 47.0 GB เกิน 32 GB ของการ์ดใบเดียว
- บริบทสั้น: Vulkan สร้างโทเคน (decode) เร็วกว่า ROCm ราว 11% (ประมาณ 40 เทียบ 36 tok/s) แต่ ROCm ประมวลผล prompt (prefill) เร็วกว่า 7–14%
- บริบทยาว: ถึง 32K สองฝั่งเท่ากัน หลัง 64K ROCm นำชัด ที่ 128K prefill 1,463 เทียบ 1,174 tok/s และรอคำตอบแรก 91 เทียบ 113 วินาที
- MTP: decode เร็วขึ้น 1.27 ถึง 1.63 เท่า (บริบทสั้น) ใช้ VRAM เพิ่มราว 3.5 GiB
- คำแนะนำ: งานป้อนเอกสารยาวเลือก ROCm งานเขียนเอาต์พุตยาวบนบริบทสั้นเลือก Vulkan ข้อควรระวังคือสองแบ็กเอนด์ใช้ llama.cpp คนละ build
ตัวเลขเด่น: decode สูงสุด ~40 tok/s (Vulkan, บริบทสั้น), prefill สูงสุด 1,974 tok/s (ROCm, 16K), TTFT ที่ 128K 91 วินาที (ROCm) และรัน valid 100% ทั้ง 130 รัน
ทดสอบอะไร และอย่างไร
หัวข้อที่มีชื่อว่า “ทดสอบอะไร และอย่างไร”Qwen3.8-Flash-Next เป็นโมเดลแบบ mixture-of-experts รวม 125B พารามิเตอร์ ใช้งานจริงครั้งละ 6B ในการทดสอบของเราใช้รุ่นที่ลดขนาดมาแล้วคือใช้ควอนต์ IQ3_XXS (~3.06 bpw) ของ ISTA-DASLab ขนาดรวม 75.8 GB แบ่งเป็น 2 shard ส่วนที่เป็นน้ำหนักหลักของโมเดลมีขนาด 47.0 GB จะถูกโหลดใน VRAM ของการ์ดจอทั้งสองตัว ส่วนตาราง n-gram อีก 28.8 GB ถูกอ่านแบบ lazy จาก SSD โดยตรงด้วย flag -lm mmap -lzm on
แต่ละชุดทดสอบวัด 1 รอบอุ่นเครื่อง (warm-up) และ 5 รอบจริง เว้น 15 วินาทีระหว่างรอบ ใช้ temperature 0, seed 1234, ปิดการคิด (thinking) ด้วย enable_thinking=false และปิด prompt cache เพื่อให้ทุกรอบ prefill ใหม่หมด ตัวเลขในรายงานคือค่ามัธยฐาน
ผลทดสอบบริบทสั้น (512 ถึง 8K)
หัวข้อที่มีชื่อว่า “ผลทดสอบบริบทสั้น (512 ถึง 8K)”| Workload | TTFT ROCm (วินาที) | TTFT Vulkan (วินาที) | Prefill ROCm (tok/s) | Prefill Vulkan (tok/s) | Decode ROCm (tok/s) | Decode Vulkan (tok/s) |
|---|---|---|---|---|---|---|
| Content 512 | 0.90 | 0.98 | 824.5 | 721.3 | 36.7 | 40.7 |
| Creative 512 | 0.83 | 0.94 | 821.5 | 709.9 | 36.4 | 40.6 |
| Summary 2K | 1.81 | 2.02 | 1,291.0 | 1,142.9 | 36.2 | 40.4 |
| Summary 4K | 2.86 | 3.09 | 1,602.0 | 1,471.8 | 35.8 | 39.9 |
| Summary 8K | 4.86 | 5.21 | 1,813.4 | 1,688.3 | 35.4 | 39.4 |
| Code analysis 4K | 2.96 | 3.19 | 1,585.7 | 1,461.6 | 35.8 | 39.9 |
| สรุปภาษาไทย | 1.47 | 1.60 | 934.6 | 835.3 | 36.1 | 40.3 |
(ตัวหนาคือฝั่งที่ดีกว่า, ตัวเลขเป็น median ของ 5 รอบ, valid 35/35 ทั้งสองฝั่ง, CV สูงสุด 0.81% (ROCm) กับ 0.89% (Vulkan))
งานที่ป้อนโจทย์สั้นแต่ให้โมเดลเขียนยาว เช่น เขียนเนื้อหาหรือเรื่องสั้น เวลาส่วนใหญ่อยู่ที่ขั้นตอนสร้างคำตอบ (decode) ซึ่ง Vulkan ทำได้เร็วกว่า
งานที่ป้อนเอกสารยาวแล้วให้สรุป เวลาส่วนใหญ่อยู่ที่ขั้นตอนอ่านเอกสาร (prefill) ซึ่ง ROCm ทำได้เร็วกว่า จึงรอคำตอบแรก (TTFT) น้อยกว่า เช่น เอกสาร 4K ROCm ใช้ 2.86 วินาที Vulkan ใช้ 3.09 วินาที และงานสรุปภาษาไทย ROCm ใช้ 1.47 วินาที Vulkan ใช้ 1.60 วินาที”
ผลทดสอบบริบทยาว (4K ถึง 128K)
หัวข้อที่มีชื่อว่า “ผลทดสอบบริบทยาว (4K ถึง 128K)”เส้นสีส้มคือ ROCm เส้นสีน้ำเงินคือ Vulkan
Prefill (tok/s): การอ่านพร้อม
หัวข้อที่มีชื่อว่า “Prefill (tok/s): การอ่านพร้อม”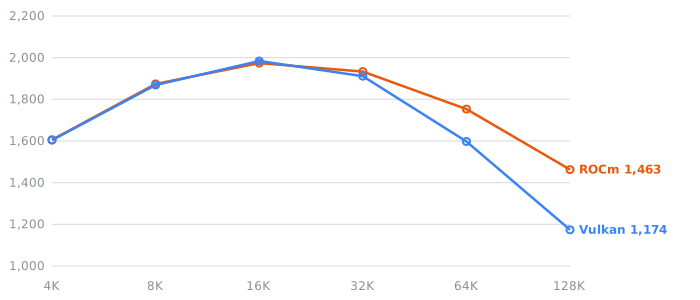
Decode (tok/s): การสร้างคำตอบ
หัวข้อที่มีชื่อว่า “Decode (tok/s): การสร้างคำตอบ”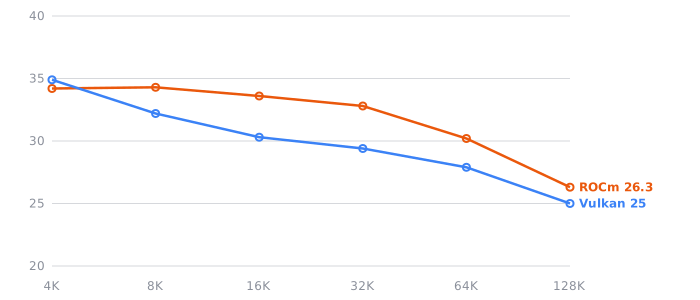
ผลทดสอบของบริบทยาว
หัวข้อที่มีชื่อว่า “ผลทดสอบของบริบทยาว”Prefill (tok/s): การอ่านพร้อม
| โมเดล | Quant | Backend | 4K | 8K | 16K | 32K | 64K | 128K |
|---|---|---|---|---|---|---|---|---|
| Qwen3.8-Flash-Next 125B | IQ3_XXS | ROCm | 1,606.0 | 1,874.0 | 1,973.7 | 1,933.1 | 1,753.1 | 1,462.8 |
| Qwen3.8-Flash-Next 125B | IQ3_XXS | Vulkan | 1,604.2 | 1,868.7 | 1,984.2 | 1,910.8 | 1,597.5 | 1,173.8 |
Decode (tok/s): การสร้างคำตอบ
| โมเดล | Quant | Backend | 4K | 8K | 16K | 32K | 64K | 128K | ลดลง 4K → 128K (%) |
|---|---|---|---|---|---|---|---|---|---|
| Qwen3.8-Flash-Next 125B | IQ3_XXS | ROCm | 34.2 | 34.3 | 33.6 | 32.8 | 30.2 | 26.3 | 23.1% |
| Qwen3.8-Flash-Next 125B | IQ3_XXS | Vulkan | 34.9 | 32.2 | 30.3 | 29.4 | 27.9 | 25.0 | 28.4% |
TTFT (วินาที): ระยะเวลาสร้างโทเคนแรก
| โมเดล | Quant | Backend | 4K | 8K | 16K | 32K | 64K | 128K |
|---|---|---|---|---|---|---|---|---|
| Qwen3.8-Flash-Next 125B | IQ3_XXS | ROCm | 4.27 | 4.72 | 8.61 | 17.57 | 38.03 | 90.90 (1.5 นาที) |
| Qwen3.8-Flash-Next 125B | IQ3_XXS | Vulkan | 4.59 | 4.75 | 8.60 | 17.78 | 41.76 | 113.12 (1.9 นาที) |
(ตัวหนาคือค่าที่ดีกว่าที่ 128K, ตัวเลขเป็น median ของ 5 รอบ, valid 30/30 ทั้งสองฝั่ง, CV สูงสุด ROCm 1.91% ส่วน Vulkan 4.25% (decode ที่ 4K) ซึ่งมีความผันผวนเกิน 3% รันยังนับเป็นผลทดสอบ, คอลัมน์ลดลงคำนวณจาก (4K − 128K) / 4K)
- ถึง 32K prefill ของสองแบ็กเอนด์ต่างกันไม่เกินราว 1%
- ที่ 128K ROCm มี prefill สูงกว่า 25% และรอคำตอบแรกสั้นกว่า 20% (90.9 เทียบ 113.1 วินาที)
- จากจุดสูงสุดที่ 16K ถึง 128K prefill ของ ROCm ลดลง 26% ของ Vulkan ลดลง 41%
- decode ของ Vulkan ลดเร็วตั้งแต่ต้น (34.9 ที่ 4K เหลือ 30.3 ที่ 16K) ขณะที่ ROCm ยังอยู่ที่ 33.6 ข้อได้เปรียบ decode ของ Vulkan ในบริบทสั้นจึงหายไป และที่ 128K ต่างกันเพียง 5%
วิเคราะห์: ทำไมผลออกมาแบบนี้
หัวข้อที่มีชื่อว่า “วิเคราะห์: ทำไมผลออกมาแบบนี้”ROCm อ่านโจทย์ (prefill) เร็วกว่า
หัวข้อที่มีชื่อว่า “ROCm อ่านโจทย์ (prefill) เร็วกว่า”prefill เป็นงานคูณเมทริกซ์ขนาดใหญ่ที่ขึ้นกับกำลังคำนวณ ไม่ใช่แบนด์วิดท์หน่วยความจำ kernel ของ ROCm ถูกออกแบบมาสำหรับงานแบบนี้บนสถาปัตยกรรมของ RDNA
Vulkan สร้างคำตอบ decode เร็วกว่าในบริบทสั้น
หัวข้อที่มีชื่อว่า “Vulkan สร้างคำตอบ decode เร็วกว่าในบริบทสั้น”decode คือการสร้างคำตอบทีละ token แม้จะมีงานคำนวณน้อยแต่จะเสียเวลากับขั้นตอนต่อ token มาก ซึ่งแบ็กเอนด์ที่เบากว่าอาจได้เปรียบ อย่างไรก็ตาม ROCm และ Vulkan ในชุดนี้ใช้ llama.cpp คนละ build ความต่างจึงรวมผลของ build เข้ามาด้วย
ทำไมบริบท 128K ยังไม่ช้าอย่างที่กลัว
หัวข้อที่มีชื่อว่า “ทำไมบริบท 128K ยังไม่ช้าอย่างที่กลัว”VRAM สูงสุดของ ROCm อยู่ที่ 46.9 GiB (บริบท 12K) และ 52.0 GiB (บริบท 128K) KV cache ที่ 128K เพิ่มขึ้นเพียงราว 5 GiB สอดคล้องกับสถาปัตยกรรมแบบผสมที่ KV cache โตช้า ผลคือ decode ที่ 128K ยังเหลือ 26.3 tok/s (ลดจาก 4K เพียง 23%) และรอคำตอบแรกประมาณ 1.5 ถึง 2 นาที
ไฟและพลังงาน
หัวข้อที่มีชื่อว่า “ไฟและพลังงาน”รอบแรกของ Vulkan (27 ต.ค.) รันก่อนแก้การแมปการ์ดที่ชื่อซ้ำ จึงไม่มีวัตต์ ต่อมา Vulkan ถูกรันซ้ำทั้งสองชุดในวันที่ 29 ต.ค. ด้วย runtime และตั้งค่าเดิม ได้ telemetry ครบทั้งรอบ (smallctx 1,052 ตัวอย่าง, longctx 1,851 ตัวอย่าง) ผลความเร็วสอดคล้องกับรอบแรก: prefill และ TTFT ต่างกันไม่เกินราว 1% และ decode ต่างไม่เกิน 1% ยกเว้นที่ 4K และ 8K ใน longctx ที่รอบซ้ำสูงกว่า 8.6% และ 14.9% ซึ่งยังไม่ทราบสาเหตุ (มีความผันผวนเกิน 3%) ตารางความเร็วด้านบนใช้ผลรอบแรกทั้งหมด
| ชุด / การ์ด | วัตต์เฉลี่ยช่วงวัดจริง (W) | วัตต์สูงสุด (W) | VRAM peak (GiB) | Tjunction สูงสุด (C) |
|---|---|---|---|---|
| Vulkan smallctx · GPU1 | 97 | 361 | 21.3 | 69 |
| Vulkan smallctx · GPU2 | 89 | 330 | 24.5 | 69 |
| Vulkan longctx · GPU1 | 239 | 409 | 24.0 | 101 |
| Vulkan longctx · GPU2 | 228 | 375 | 27.7 | 92 |
(ROCm รวมสองการ์ด: smallctx เฉลี่ย 268 W, VRAM peak 46.9 GiB · longctx เฉลี่ย 517 W, VRAM peak 52.0 GiB)
เทียบวัตต์เฉลี่ยระหว่างสองแบ็กเอนด์ตรง ๆ ยังไม่ได้ เพราะยังไม่ได้ยืนยันว่านิยามค่าเฉลี่ยของชุด ROCm (ทั้งรอบหรือเฉพาะช่วงวัด) ตรงกับของ Vulkan GPU1 ร้อนถึง 101 C ใน longctx ของ Vulkan ยังไม่ได้ตรวจว่า clock ถูกลดหรือไม่
ฝั่ง ROCm กำลังไฟเฉลี่ยรวมสองการ์ดอยู่ที่ 268 W ใน smallctx และ 517 W ใน longctx ที่ prefill หนักต่อเนื่อง
ทำไม decode ยังไม่ถึงเพดาน
หัวข้อที่มีชื่อว่า “ทำไม decode ยังไม่ถึงเพดาน”decode ราว 36 ถึง 40 tok/s ต่ำกว่าเพดานแบนด์วิดท์ที่คำนวณจากพารามิเตอร์ที่ใช้งานจริง 6B มาก สาเหตุที่น่าจะเป็นคือ layer split ให้การ์ดสองใบทำงานต่อกันทีละใบ ไม่ใช่ขนานกัน และมีภาระอ่านตาราง n-gram แต่ยังไม่ได้ทดสอบยืนยัน ผลทดสอบก่อนหน้าบน R9700 x2 ชี้ว่าไม่มีลิงก์ความเร็วสูงระหว่างการ์ด tensor split จึงช้ากว่า และ row split ใช้ไม่ได้ใน llama.cpp ชุดนี้ จึงเลือก layer split
การโหลดโมเดลและการใช้พื้นที่หน่วยความจำ
หัวข้อที่มีชื่อว่า “การโหลดโมเดลและการใช้พื้นที่หน่วยความจำ”โมเดลไฟล์รวม 75.8 GB (70.63 GiB) ไม่ได้ถูกโหลดขึ้น VRAM ทั้งหมด เพราะว่ามันไม่พอ ส่วนที่เป็นน้ำหนักหลักของโมเดลถูกคัดลอกเข้า VRAM ของสองการ์ด ส่วนตาราง n-gram embedding รายชั้นถูก map จากไฟล์ (mmap) และอ่านตามแถวเมื่อจำเป็น ตัวเลขทุกตัวด้านล่างติดป้ายว่ามาจากไหน: วัด คือวัดตอนรันจริง, log คือที่ llama-server รายงาน, ประมาณ คือยังไม่ได้วัด
SSD (NVMe) ├─ shard 1 47.0 GB น้ำหนักหลัก 48 block + output │ └─► VRAM (คัดลอกตอนโหลด, layer split 49/49 layer) │ GPU1 (ROCm0, PCI 03:00.0) 20.24 GiB │ GPU2 (ROCm1, PCI 47:00.0) 23.31 GiB ├─ shard 2 28.8 GB ตาราง n-gram embedding รายชั้น │ └─► RAM แบบ mmap (CPU_Mapped 27.08 GiB) │ ไม่ copy เข้า VRAM, flag -lzm on = อ่านเฉพาะแถวที่ใช้จาก page cache/SSD │ process ถือไว้ใน RAM จริงน้อยกว่า 1 GiB (file-backed RSS 0.46 ถึง 0.86 GiB) └─ MTP draft 2.79 GB (mtp-...shared-Q8_0.gguf) └─► VRAM GPU2 เท่านั้น 2.58 GiB [log] ไม่ใช้ RAM เพิ่ม (ไม่มี embedding ของตัวเอง ใช้ embedding/output ของโมเดลหลักร่วมกัน)เปรียบเทียบการใช้ VRAM ปิด MTP vs เปิด MTP
หัวข้อที่มีชื่อว่า “เปรียบเทียบการใช้ VRAM ปิด MTP vs เปิด MTP”| รายการ (GiB) | ปิด MTP | เปิด MTP (n-max 5) | ที่มา |
|---|---|---|---|
| VRAM GPU1 หลังโหลด | 21.55 | 21.87 (+0.32) | บันทีกระหว่างทดสอบ |
| VRAM GPU2 หลังโหลด | 24.73 | 27.87 (+3.14) | บันทีกระหว่างทดสอบ |
| VRAM GPU1 / GPU2 หลังยิง request (prompt 9,554 token, gen 256) | 21.70 / 24.88 | 22.02 / 28.06 | บันทีกระหว่างทดสอบ |
| ส่วนเพิ่มบน GPU2: draft model | – | 2.58 | อ่านจาก log |
| ส่วนเพิ่มบน GPU2: KV 0.02 + compute 0.25 + RS ราว 0.26 | – | ราว 0.53 | อ่านจาก log (รวมเป็นค่าประมาณ) |
| RSS ของ process หลังโหลด | 1.09 | 1.33 | บันทีกระหว่างทดสอบ |
| RSS ของ process หลัง request | 2.25 | 2.82 | บันทีกระหว่างทดสอบ |
| CPU_Mapped (mmap) | 27.08 | 27.08 (เท่าเดิม) | อ่านจาก log |
(VRAM สูงสุดของ ROCm ในการทดสอบ smallctx: ไม่มี MTP 46.9 GiB และมี MTP 50.1 GiB รวมสองการ์ด)
- MTP ใช้ VRAM เพิ่มราว 3.5 GiB และทั้งหมดไปอยู่ที่ GPU2 จึงหนักกว่า GPU1 (VRAM 28.5 เทียบ 22.4 GiB)
- MTP ไม่ใช้ RAM หรือ buffer ฝั่ง CPU เพิ่มอย่างมีนัยสำคัญ
- “CPU_Mapped” เป็นชื่อ buffer ใน log หมายถึงเทนเซอร์ที่ map จากไฟล์และไม่ได้ย้ายเข้า VRAM ไม่ได้แปลว่าคำนวณบน CPU
- ระหว่างรอบวัดที่ page cache ของเครื่องเก็บไฟล์โมเดลไว้แล้ว (buff/cache ราว 52 GB จาก RAM 65.4 GB) ปริมาณอ่านจาก SSD ระหว่าง request เกือบ 0 [วัด]
- ประมาณ ยังไม่ได้วัด: ตอน cold start ครั้งแรกหลังเปิดเครื่อง ระบบน่าจะต้องอ่านไฟล์จาก SSD ในขนาดใกล้ไฟล์โมเดล ค่านี้ไม่ได้วัดเพราะต้องล้างแคชด้วยสิทธิ์ root และเครื่องไม่มีเครื่องมือแยก page cache รายไฟล์
ทดลองเพิ่ม: speculative decoding แบบ MTP
หัวข้อที่มีชื่อว่า “ทดลองเพิ่ม: speculative decoding แบบ MTP”MTP (multi-token prediction) ใช้หัวทำนายขนาดเล็ก 2.79 GB เดาหลาย token ล่วงหน้า แล้วให้โมเดลหลักตรวจรวดเดียว ทดสอบด้วยไฟล์ mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf (Unsloth) --spec-type draft-mtp --spec-draft-n-max 5 บน ROCm layer split สองการ์ด ตั้งค่าเหมือน smallctx เดิม (1 warm-up + 5 รัน) ทุก workload valid 5/5
llama.cpp ตัวเดิมที่ใช้ในการทดสอบหลักโหลดไฟล์ MTP ไม่ได้ จึงต้อง build fork (branch qwen4exp/mtp commit 6fcaa16f4) ด้วย ROCm 10 SDK บวก -O3 ตัวควบคุมคือ fork ตัวเดียวกันแบบไม่มี draft ซึ่ง decode ได้ 33 ถึง 35 tok/s เท่า build เดิม
| Workload | Decode build เดิม (tok/s) | Decode fork ไม่มี draft (tok/s) | Decode MTP (tok/s) | เร็วขึ้นเทียบ fork |
|---|---|---|---|---|
| Content 512 | 36.7 | 34.6 | 44.0 | x1.27 |
| Creative 512 | 36.4 | 34.7 | 44.4 | x1.28 |
| Summary 2K | 36.2 | 33.8 | 51.6 | x1.53 |
| Summary 4K | 35.8 | 33.7 | 55.1 | x1.63 |
| Summary 8K | 35.4 | 33.2 | 53.7 | x1.62 |
| Code analysis 4K | 35.8 | 34.6 | 49.5 | x1.43 |
| สรุปภาษาไทย | 36.1 | 35.4 | 46.2 | x1.31 |
(ค่ามัธยฐาน เทียบกับ build เดิมเร็วขึ้น x1.20 ถึง x1.54 draft เดาถูกรวม 41.8% (8,251 จาก 19,759) CV ของ decode MTP 0.2 ถึง 2.1% ยกเว้น Content 512 ที่ 4.3% (มีความผันผวนเกิน 3%))
- MTP ได้ผลมากที่สุดกับงานสรุปเอกสาร (x1.5 ถึง x1.6) เพราะข้อความสรุปเดาล่วงหน้าได้ง่ายกว่างานเขียนสร้างสรรค์ (x1.3)
- เทียบ prefill และ TTFT ตรง ๆ ไม่ได้ เพราะ fork แบบไม่มี draft มี prefill ผันผวนมาก (CV 4 ถึง 41% แบ่งเป็นสองระดับ ราว 370 กับ 820 tok/s) จึงมีความผันผวนเกิน 3% ใช้ decode เป็นตัวเทียบหลัก
- ข้อความที่ได้ขึ้นต้นเหมือนรอบเดิมและอ่านได้สมเหตุสมผล ยังไม่ได้ตรวจความถูกต้องเชิงเนื้อหาครบทุก workload
- ยังไม่ได้ทดสอบ MTP กับบริบทยาว และไฟล์ MTP ตัวที่สอง (drluoto) ที่โหลดไม่ได้กับ build ที่มี ต้องใช้ fork อีกตัว
ข้อจำกัดที่ต้องรู้
หัวข้อที่มีชื่อว่า “ข้อจำกัดที่ต้องรู้”- ไม่ใช่การเทียบแบ็กเอนด์ล้วน ๆ ROCm ใช้ llama.cpp v0.7.0-dev commit 620d222 ส่วน Vulkan ใช้ build ของ LM Studio commit ead9f32 คอมไพล์ด้วย GCC คนละรุ่น
- ค่าวัตต์ของ Vulkan มาจากรอบรันซ้ำ (29 ต.ค.) ไม่ใช่รอบที่ใช้ทำตารางความเร็ว และนิยามค่าเฉลี่ยกับ ROCm ยังไม่ได้ยืนยันว่าตรงกัน
- วัดความเร็วเท่านั้น ควอนต์ IQ3_XXS ตัวเดียว ยังไม่ได้วัดคุณภาพคำตอบเทียบควอนต์ที่สูงกว่า
- ยังไม่ได้ทดสอบ MTP กับบริบทยาว, หลายผู้ใช้พร้อมกัน (concurrent) และการแบ่งแบบอื่นกับโมเดลนี้
- runtime ทั้งสองไม่ได้ลงทะเบียนใน registry ของ PromptMark ระบบบันทึกเป็น
unregistered-pathและเพิ่ม flag ผ่าน wrapper ไม่ได้แก้โค้ด
ข้อสรุปและคำแนะนำ
หัวข้อที่มีชื่อว่า “ข้อสรุปและคำแนะนำ”- R9700 x2 (VRAM รวม 64 GB) รันโมเดลระดับ 125B แบบ MoE ได้จริง decode 35 ถึง 41 tok/s, prefill ราว 1.6 ถึง 2.0 พัน tok/s
- เลือก ROCm สำหรับสรุปเอกสารยาว งาน RAG บริบทตั้งแต่ 64K และเมื่อต้องการอ่านค่าไฟและ VRAM
- เลือก Vulkan สำหรับงานเขียนเอาต์พุตยาวบนบริบทสั้น ที่ decode เร็วกว่าราว 11% โดยรู้ว่าข้อได้เปรียบนี้หมดไปเมื่อบริบทยาวขึ้น
- ถ้าต้องการ decode ที่เร็วขึ้น MTP เพิ่ม decode ราว 1.3 ถึง 1.6 เท่า แลกกับ VRAM เพิ่มราว 3.5 GiB บน GPU2 (ผลทดสอบบริบทสั้นเท่านั้น)
- ตอนนี้มีโปรเจคพิเศษที่ได้รับความนิยมอย่าง STARTA ที่ทำออกมาเพื่อโมเดลบางรุ่นอย่าง Qwen Flash Next โดยเฉพาะ ทำให้รันได้เร็วกว่าการใช้ llama.cpp ซึ่งเป็นโครงการที่น่าสนใจมากครับ
ข้อมูลการทดสอบ
หัวข้อที่มีชื่อว่า “ข้อมูลการทดสอบ”| รายการ | รายละเอียด |
|---|---|
| เครื่อง | AIPC · AMD Ryzen 7 7700 (16 เธรด) · RAM 65.4 GB · BIOS 3.40 · Ubuntu 26.04.1 LTS · kernel 7.0.0-38-generic |
| การ์ด | AMD Radeon AI PRO R9700 x2 (Navi 48, 32 GB ต่อใบ, GPU1 = PCI 03:00.0, GPU2 = PCI 47:00.0, power cap 300 W ต่อใบ, ลิงก์การ์ด PCIe 5.0 x16, driver amdgpu) |
| ROCm | llama.cpp 0.7.0-dev (build 1, commit 620d222, GCC 15.2.0), ROCm stack 10.0.0, HIP_VISIBLE_DEVICES=0,1 |
| Vulkan | LM Studio backend 2.62.1 (0.7.0-dev, build 1, commit ead9f32, GCC 12.3.0), Mesa 26.2.4 RADV GFX1201, --device Vulkan1,Vulkan2 |
| โมเดล | Qwen3.8-Flash-Next-GSQ-RCO IQ3_XXS (ISTA-DASLab, 2 shard รวม 75.8 GB, สถาปัตยกรรม qwen4exp) ตรวจ sha256 ตรงกับต้นทาง |
| flag | -sm layer -ngl 999 --fit off -np 1 --no-cache-prompt --slot-prompt-similarity 0.0 --no-context-shift -lm mmap -lzm on (smallctx ใช้ -c 12288) |
| วิธีวัด | 1 warm-up + 5 รัน ค่ามัธยฐาน, หน่วงระหว่างรอบ 15 วินาที, temperature 0, seed 1234, ignore_eos, ปิด thinking, ชุด smallctx 7 workload และ longctx 4K ถึง 128K, PromptMark 0.5.0 |
| ความผันผวน (CV) | smallctx ต่ำกว่า 0.9% ทั้งสองฝั่ง · longctx ROCm สูงสุด 1.91% · longctx Vulkan สูงสุด 4.25% (มีความผันผวนเกิน 3%) |
| runtime ทดลอง MTP | llama.cpp fork qwen4exp/mtp (commit 6fcaa16f4, build ด้วย ROCm 10 SDK และ -O3) ไฟล์ draft mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf, --spec-type draft-mtp --spec-draft-n-max 5 |
| telemetry | ROCm และ Vulkan (รอบรันซ้ำ 29 ต.ค.) อ่านค่าทั้งสองการ์ดจาก amdgpu sysfs/hwmon ทุก 1 วินาที (วัตต์ อุณหภูมิ VRAM) · Vulkan รอบแรก 27 ต.ค. ไม่มี telemetry |
| ผลดิบ | results/R9700-x2-flash-next/ (smallctx, longctx, REPORT.md, ANALYSIS.md) |
ทดสอบด้วย PromptMark v0.5.0