llama.cpp v0.8.0 อัปเดต เพิ่มโมเดลใหม่ ปรับปรุง MoE และ GPU Backend พร้อมรองรับ Realtime API
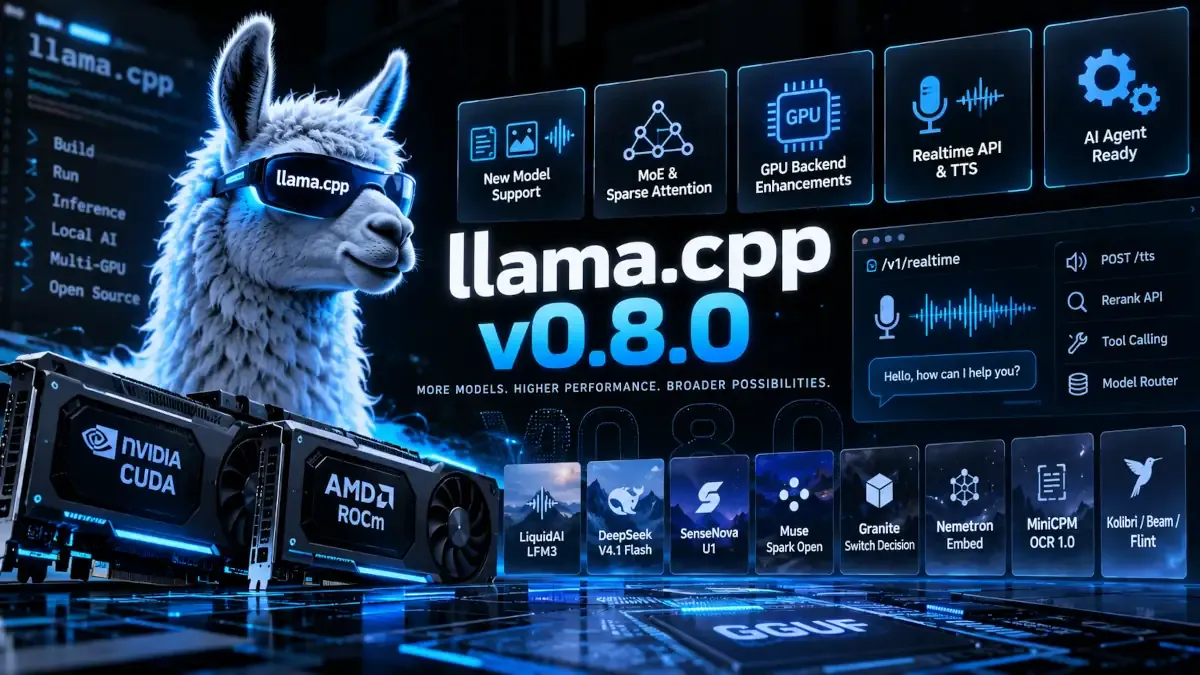
llama.cpp อัปเดตเป็นเวอร์ชัน 0.8.0 เพิ่มความสามารถในการรองรับโมเดล AI สถาปัตยกรรมใหม่ พร้อมปรับปรุงการประมวลผล Mixture of Experts (MoE), Sparse Attention และ GPU Backend หลายแพลตฟอร์ม นอกจากนี้ยังขยายความสามารถของ Server API ด้วย Realtime API สำหรับงานเสียง, Text-to-Speech (TTS) และฟีเจอร์ที่เกี่ยวข้องกับ AI Agent
การอัปเดตครั้งนี้มีความสำคัญต่อผู้ที่ใช้งาน Local LLM เพราะ llama.cpp เป็นหนึ่งใน Runtime ที่นิยมใช้รันโมเดลในรูปแบบ GGUF บนฮาร์ดแวร์หลากหลายประเภท ตั้งแต่ CPU ไปจนถึง GPU ของ NVIDIA, AMD และแพลตฟอร์มอื่นที่มี Backend รองรับ
อย่างไรก็ตาม การเพิ่มความสามารถในระดับ Backend ผู้ใช้ยังจำเป็นต้องตรวจสอบความเข้ากันได้ของสถาปัตยกรรมโมเดลและฮาร์ดแวร์ที่ใช้งานจริง ก่อนที่จะใช้เป็นเครื่องมือหลักในการรันโมเดล
รองรับโมเดลและสถาปัตยกรรมใหม่
หัวข้อที่มีชื่อว่า “รองรับโมเดลและสถาปัตยกรรมใหม่”หนึ่งในการเปลี่ยนแปลงสำคัญของ llama.cpp v0.8.0 คือการขยายการรองรับโมเดล AI รุ่นใหม่ ครอบคลุมทั้งโมเดลภาษา โมเดลมัลติโมดัล และโมเดลสำหรับงานเฉพาะทาง
รายการที่ระบุใน Release Notes ได้แก่
- LiquidAI LFM3: เพิ่มการรองรับโมเดลในกลุ่มข้อความ ภาพ เสียง และ Omni
- DeepSeek V4.1 Flash: เพิ่มการรองรับสถาปัตยกรรมโมเดล
- SenseNova U1: เพิ่มการรองรับโมเดล
- Muse Spark Open: รองรับงานที่เกี่ยวข้องกับข้อความ ภาพ และเสียง
- Granite Switch Decision: เพิ่มการรองรับโมเดลสำหรับงานตัดสินใจ รวมถึง Decision Head แบบ 256 ทาง
- Nemotron-3(.5)-Embed: เพิ่มการรองรับโมเดล Embedding พร้อมองค์ประกอบที่เกี่ยวข้อง เช่น Grouped Query Attention (GQA)
- MiniCPM-OCR 1.0: เพิ่มการรองรับโมเดลสำหรับงาน OCR
- Kolibri-1, Beam และ Flint: เพิ่มการรองรับสถาปัตยกรรมโมเดลเพิ่มเติม
การเพิ่ม Model Support มีความสำคัญต่อผู้ใช้ Local AI เพราะช่วยขยายตัวเลือกโมเดลที่สามารถนำมาทดลองผ่าน Runtime เดียวกันได้ แต่ความสามารถที่ใช้งานได้จริงยังขึ้นอยู่กับการแปลงโมเดลเป็น GGUF, Tensor ที่สถาปัตยกรรมต้องใช้ และระดับการรองรับของแต่ละฟีเจอร์
ผู้ใช้จึงควรตรวจสอบทั้งชื่อโมเดล รูปแบบไฟล์ และข้อกำหนดของโมเดลแต่ละตัวก่อนดาวน์โหลดหรือย้ายระบบไปใช้เวอร์ชันใหม่
ปรับปรุงการทำงานของ MoE และ Sparse Attention
หัวข้อที่มีชื่อว่า “ปรับปรุงการทำงานของ MoE และ Sparse Attention”llama.cpp v0.8.0 ปรับปรุงองค์ประกอบภายในที่เกี่ยวข้องกับการประมวลผลโมเดลขนาดใหญ่ โดยเฉพาะ Mixture of Experts (MoE) และ Sparse Attention
ปรับปรุง Expert Cache สำหรับโมเดล MoE
หัวข้อที่มีชื่อว่า “ปรับปรุง Expert Cache สำหรับโมเดล MoE”การจัดการ Expert Cache เปลี่ยนจาก LRU (Least Recently Used) เป็น SLRU (Segmented Least Recently Used) โดยแบ่งสัดส่วนแคช 50/50 เพื่อปรับวิธีเก็บ Expert ที่อาจถูกเรียกใช้งานซ้ำ
การเปลี่ยนแปลงนี้เกี่ยวข้องกับโมเดล MoE ซึ่งเลือกใช้ Expert เพียงบางส่วนในการประมวลผลแต่ละ Token แทนการใช้พารามิเตอร์ทั้งหมดเหมือนโมเดล Dense ทั่วไป
การจัดการแคชที่เหมาะสมอาจช่วยลดภาระในการนำ Expert กลับมาใช้งาน แต่ผลลัพธ์จริงจะขึ้นอยู่กับรูปแบบการเรียก Expert, ขนาดโมเดล และข้อจำกัดของ RAM กับ VRAM ไม่ควรสรุปว่าจะทำให้ทุกโมเดลใช้หน่วยความจำน้อยลงหรือสร้าง Token ได้เร็วขึ้นเสมอ
ปรับปรุง Sparse Attention
หัวข้อที่มีชื่อว่า “ปรับปรุง Sparse Attention”เวอร์ชันนี้ยังปรับปรุงเส้นทางการทำงานที่เกี่ยวข้องกับ QSA/DSA โดยใช้ Fused Masking Operation และปรับการจัดการข้อมูลที่ใช้ร่วมกันระหว่าง Layer
การปรับปรุงระดับนี้อาจช่วยเพิ่มประสิทธิภาพให้กับโมเดลที่ใช้กลไก Attention ดังกล่าว แต่ไม่ได้หมายความว่าโมเดล Transformer ทุกชนิดจะได้รับประโยชน์เท่ากัน
นอกจากนี้ ยังมีการปรับปรุงการจัดการ Memory Cache, การทำงานในโหมด no_alloc และกระบวนการโหลด Vocabulary เพื่อให้การจัดการหน่วยความจำมีความเหมาะสมมากขึ้น
เพิ่มความสามารถด้านเสียงและ Realtime API
หัวข้อที่มีชื่อว่า “เพิ่มความสามารถด้านเสียงและ Realtime API”อีกหนึ่งส่วนที่น่าสนใจคือการขยายความสามารถของ llama.cpp Server ให้รองรับงานเสียงและการโต้ตอบแบบเรียลไทม์มากขึ้น
Streaming Audio API
หัวข้อที่มีชื่อว่า “Streaming Audio API”มีการเพิ่ม API ทดลอง mtmd_audio_stream สำหรับรับข้อมูลเสียง PCM อย่างต่อเนื่อง และแปลงข้อมูลเข้าสู่กระบวนการประมวลผลที่เกี่ยวข้อง
ความสามารถนี้เป็นพื้นฐานสำหรับการพัฒนาระบบที่ต้องรับเสียงระหว่างที่ผู้ใช้กำลังพูด แทนการรอให้ผู้ใช้ส่งไฟล์เสียงจนเสร็จแล้วจึงเริ่มประมวลผล
Realtime API
หัวข้อที่มีชื่อว่า “Realtime API”เพิ่ม Endpoint /v1/realtime โดยอิงรูปแบบโปรโตคอล OpenAI Realtime API เพื่อรองรับการโต้ตอบและงานเสียงตามความสามารถของระบบที่นำมาใช้งาน
Text-to-Speech
หัวข้อที่มีชื่อว่า “Text-to-Speech”เพิ่ม Endpoint POST /tts สำหรับการสร้างเสียงพูดด้วยโมเดลที่รองรับ
การเปลี่ยนแปลงเหล่านี้ช่วยเพิ่มทางเลือกให้ผู้พัฒนาที่ต้องการสร้างระบบ Local AI ซึ่งรับเสียง ประมวลผลข้อความ และตอบกลับด้วยเสียงผ่าน Runtime ที่ติดตั้งบนเครื่องของตนเอง
อย่างไรก็ตาม Endpoint เหล่านี้ไม่ได้ทำให้โมเดลภาษาแบบข้อความทั่วไปกลายเป็นโมเดลเสียงโดยอัตโนมัติ ผู้ใช้ต้องตรวจสอบว่าโมเดลและองค์ประกอบที่ติดตั้งรองรับงานเสียงที่ต้องการจริงหรือไม่
ปรับปรุง GPU Backend และการประมวลผลหลาย GPU
หัวข้อที่มีชื่อว่า “ปรับปรุง GPU Backend และการประมวลผลหลาย GPU”สำหรับผู้ที่ใช้ GPU เร่งความเร็วการประมวลผล LLM llama.cpp v0.8.0 มีการเปลี่ยนแปลงใน Backend หลายส่วน
| Backend | การเปลี่ยนแปลงสำคัญ |
|---|---|
| CUDA | ปรับปรุง Fused MoE Top-K, Gate/Up + GLU และ Chunked Graph Launches |
| SYCL | เพิ่มความสามารถ Graph Record/Replay |
| OpenCL | เพิ่ม Kernel สำหรับ Quantization บางรูปแบบ เช่น Q2_K และ Q3_K |
| Vulkan | ปรับปรุง Subgroup Reduction และความแม่นยำของ src1 |
| Tensor Parallel | เพิ่มการรองรับในสถาปัตยกรรม stepfun และ laguna สำหรับการใช้งาน GPU หลายตัวตามขอบเขตที่ระบุ |
การเปลี่ยนแปลงเหล่านี้สะท้อนให้เห็นว่า llama.cpp ยังคงพัฒนาการรองรับฮาร์ดแวร์ที่หลากหลาย ไม่ได้จำกัดเฉพาะ GPU ของ NVIDIA เท่านั้น
สำหรับการใช้ GPU หลายตัว ต้องแยกการทำงานแต่ละรูปแบบออกจากกัน ได้แก่
- Layer Split: กระจาย Layer ของโมเดลไปยัง GPU แต่ละตัว
- Row Split: แบ่งการคำนวณตามแถวของ Tensor
- Tensor Split: กระจายการคำนวณ Tensor ระหว่าง GPU
ตอนนี้การใช้งานแบบ Tensor Parallel จะถูกจำกัดกับบางโมเดลบางสถาปัตยกรรมเท่านั้น ไม่สามารถใช้ได้กับทุกโมเดลผู้ใช้ต้องตรวจสอบข้อจำกัดของสถาปัตยกรรมและ Backend ก่อน
ปรับปรุง Server API สำหรับ AI Agent และ RAG
หัวข้อที่มีชื่อว่า “ปรับปรุง Server API สำหรับ AI Agent และ RAG”llama.cpp v0.8.0 ยังมีการปรับปรุงส่วน Server และ API ที่เกี่ยวข้องกับการนำโมเดลไปใช้งานในระบบจริง
Model Router เพิ่มการกำหนด Memory Margin สำหรับการนำโมเดลออกจากอุปกรณ์โดยอัตโนมัติ ช่วยให้ผู้พัฒนาควบคุมการจัดการหน่วยความจำในระบบที่มีการสลับโมเดลได้ละเอียดขึ้น
Rerank API ปรับปรุงการรับ Input แบบมีชนิดข้อมูลและการจัดการ Placeholder ที่เกี่ยวข้องกับ Template ซึ่งเป็นองค์ประกอบสำคัญสำหรับระบบค้นคืนข้อมูลที่ใช้โมเดล Reranker
Tool Calling เพิ่มการรองรับ Deferred Tools และ tool_reference ใน Chat API เพื่อขยายความสามารถในการเชื่อมต่อโมเดลกับเครื่องมือภายนอก
Reasoning Effort เพิ่มช่องทางให้กำหนดระดับ Reasoning ผ่าน API เมื่อ Template ของโมเดลรองรับ
สำหรับระบบ RAG การปรับปรุง Rerank API อาจช่วยให้การเชื่อมต่อองค์ประกอบต่าง ๆ ทำได้สะดวกขึ้น แต่ llama.cpp ไม่ได้สร้างระบบ RAG ให้ครบวงจรโดยอัตโนมัติ ผู้พัฒนายังต้องจัดเตรียมระบบจัดเก็บเอกสาร การค้นคืนข้อมูล Embedding และขั้นตอนจัดอันดับผลลัพธ์ตามความต้องการของระบบ
ในทำนองเดียวกัน การเพิ่มความสามารถ Tool Calling ที่ฝั่ง API ไม่ได้รับประกันว่าโมเดลทุกตัวจะเรียกเครื่องมือได้ถูกต้อง เพราะผลลัพธ์ยังขึ้นอยู่กับการฝึกโมเดล รูปแบบ Chat Template และการจัดการ Tool Call ของแอปพลิเคชัน
มีการเปลี่ยนแปลงที่ผู้ใช้งานเดิมควรทราบ
หัวข้อที่มีชื่อว่า “มีการเปลี่ยนแปลงที่ผู้ใช้งานเดิมควรทราบ”ผู้ที่อัปเดตจากเวอร์ชันก่อนหน้าควรตรวจสอบสคริปต์และการตั้งค่าที่ใช้อยู่ด้วย
- คำสั่ง CLI: การเรียกใช้งานต้องระบุ
--modelหรือ-hfไม่ควรพึ่งพาคำสั่งเดิมที่ไม่ได้ระบุโมเดล - Grammar และ JSON: มีการจำกัดความลึกของ Recursion เพื่อป้องกันปัญหา Stack Overflow และปฏิเสธ JSON ที่ซับซ้อนเกินขอบเขตที่กำหนด
- GGUF Tools: ปรับการตรวจจับ Tensor Data ที่ถูกตัดทอนในเครื่องมือ
split,export-loraและmerge - Tensor Parallel: มีข้อจำกัดตามสถาปัตยกรรมโมเดล โดยบางสถาปัตยกรรมไม่รองรับการใช้
-sm tensor
ผู้ที่ใช้สคริปต์อัตโนมัติหรือ Runtime ที่ปรับแต่งเองควรทดสอบคำสั่งเดิมก่อนนำเวอร์ชันใหม่ไปแทนระบบหลัก โดยเฉพาะระบบที่ใช้การแบ่งโมเดลหลาย GPU หรือมีการจัดการ Context และหน่วยความจำเป็นพิเศษ
สรุป: llama.cpp v0.8.0 น่าสนใจสำหรับผู้ใช้ Local AI
หัวข้อที่มีชื่อว่า “สรุป: llama.cpp v0.8.0 น่าสนใจสำหรับผู้ใช้ Local AI”llama.cpp v0.8.0 เป็นการอัปเดตที่ขยายขอบเขตการใช้งานทั้งด้านโมเดล AI, การประมวลผล MoE, GPU Backend, งานเสียง และ API สำหรับระบบ Agent
สำหรับผู้ใช้ทั่วไป จุดที่ควรเริ่มตรวจสอบคือการรองรับโมเดลที่ต้องการใช้งาน ส่วนผู้พัฒนาระบบ Local AI ควรให้ความสำคัญกับการเปลี่ยนแปลงของ Server API, Rerank API และ Tool Calling ขณะที่ผู้ใช้ GPU หลายตัวควรทดสอบประสิทธิภาพจริงแยกตาม Backend และรูปแบบการแบ่งงาน
การอัปเดตครั้งนี้จึงเป็นโอกาสในการทดลองความสามารถใหม่ แต่ไม่ควรถือว่าการเปลี่ยนเวอร์ชันจะทำให้ทุกโมเดลเร็วขึ้นหรือแก้ปัญหาความเข้ากันได้ทั้งหมดโดยอัตโนมัติ