llama.cpp v0.6.0 อัปเดตใหญ่สำหรับ Local AI ปรับปรุง MTP, DFlash, Vulkan รองรับโมเดลรุ่นใหม่ และเพิ่ม API สำหรับ Decision Models
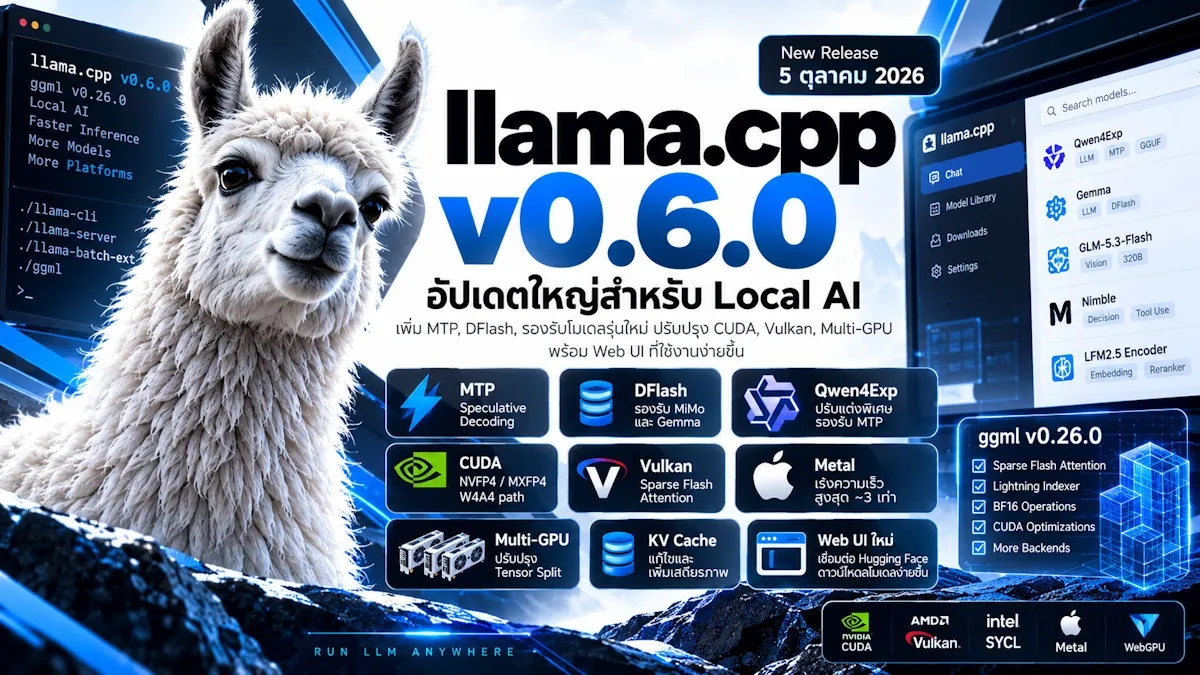
llama.cpp โครงการโอเพนซอร์สสำหรับการรัน Large Language Model (LLM) บนเครื่องของผู้ใช้ เปิดตัว v0.6.0 เมื่อวันที่ 5 ตุลาคม 2026 โดยเป็นการอัปเดตครั้งสำคัญที่ไม่ได้เน้นเพียงการเพิ่มโมเดลใหม่ แต่ยังปรับโครงสร้างภายในของ runtime, API สำหรับ inference, speculative decoding, Web UI และ backend สำหรับ GPU หลายแพลตฟอร์ม
การอัปเดตครั้งนี้ยังมาพร้อม ggml v0.26.0 ซึ่งเพิ่ม kernel และการปรับปรุงด้านประสิทธิภาพหลายส่วน ทำให้ llama.cpp มีความพร้อมมากขึ้นสำหรับโมเดลยุคใหม่ที่มีโครงสร้างซับซ้อนกว่า LLM แบบ Transformer ทั่วไป
MTP และ llama_batch_ext เป็นหนึ่งในการเปลี่ยนแปลงสำคัญ
หัวข้อที่มีชื่อว่า “MTP และ llama_batch_ext เป็นหนึ่งในการเปลี่ยนแปลงสำคัญ”จุดที่น่าสนใจที่สุดของ llama.cpp v0.6.0 คือการเพิ่ม API ใหม่ชื่อ llama_batch_ext พร้อม llama_process() ซึ่งออกแบบมาเพื่อรองรับ batch ที่สามารถผสมทั้ง token และ embedding รวมถึง state embedding แบบ per-token สำหรับโมเดลที่ใช้ MTP (Multi-Token Prediction) และ DeepStack
การเปลี่ยนแปลงนี้มีความสำคัญต่อการพัฒนา speculative decoding เพราะ runtime สามารถจัดการข้อมูลที่มีโครงสร้างซับซ้อนมากขึ้นได้โดยตรง และโครงการได้ย้ายส่วนสำคัญอย่าง speculative decoding, multimodal และ server มาใช้ API ใหม่นี้แล้ว
สำหรับ Qwen4Exp llama.cpp v0.6.0 เพิ่มการรองรับ MTP speculative decoding และโครงการรายงานว่าสามารถเพิ่มความเร็วในการ decode ได้ประมาณ 1.5 เท่า ในการทดสอบบน NVIDIA DGX Spark ทั้งนี้ตัวเลขดังกล่าวเป็นผลทดสอบของโครงการ ไม่ควรนำไปตีความว่า GPU หรือโมเดลทุกชุดจะได้ความเร็วเพิ่มขึ้นเท่ากัน
DFlash ได้รับการปรับปรุงเพิ่มเติม
หัวข้อที่มีชื่อว่า “DFlash ได้รับการปรับปรุงเพิ่มเติม”v0.6.0 ยังมีการอัปเดตส่วนที่เกี่ยวข้องกับ DFlash drafts โดยเพิ่มการรองรับ DFlash สำหรับ MiMo และแก้ไขกระบวนการแปลงโมเดล Gemma ให้สามารถเขียน embedding scale สำหรับ DFlash ได้ถูกต้อง
DFlash เป็นอีกแนวทางหนึ่งของการทำ speculative decoding ดังนั้นการเปลี่ยนแปลงในส่วนนี้มีความสำคัญกับผู้ใช้ที่ต้องการทดลองเร่งความเร็วการ generate token บนโมเดลที่รองรับ แต่ไม่ได้หมายความว่าโมเดล GGUF ทุกตัวจะสามารถใช้ DFlash ได้ทันที
Qwen4Exp ได้รับการปรับแต่งหลายด้าน
หัวข้อที่มีชื่อว่า “Qwen4Exp ได้รับการปรับแต่งหลายด้าน”นอกจาก MTP แล้ว Qwen4Exp ยังได้รับ optimization หลายรายการใน v0.6.0 เช่น
- ลด memory ที่ใช้กับ indexer score ลงประมาณครึ่งหนึ่ง
- ปรับปรุงการสร้าง mask
- เปิดการใช้งาน
-smtensor กลับมา - ปรับปรุง speculative decoding และ MTP
- แก้ไขปัญหาด้าน correctness หลายรายการ
การลด memory ของ indexer มีความน่าสนใจเป็นพิเศษสำหรับระบบที่มีข้อจำกัดด้าน VRAM เพราะ Qwen4Exp เป็นโมเดลที่มีองค์ประกอบด้าน indexer และ attention ซับซ้อนกว่าการรัน LLM ทั่วไป
CUDA รองรับ W4A4 และ NVFP4/MXFP4
หัวข้อที่มีชื่อว่า “CUDA รองรับ W4A4 และ NVFP4/MXFP4”ฝั่ง GPU ก็มีการเปลี่ยนแปลงที่น่าสนใจ โดย llama.cpp เพิ่ม model-driven W4A4 mul_mat path ซึ่งรองรับรูปแบบความละเอียดต่ำอย่าง NVFP4 และ MXFP4 บน CUDA
นอกจากนี้ ggml v0.26.0 ยังเพิ่ม MMVQ shared-expert fusion และการปรับปรุง Lightning Indexer รวมถึง optimization อื่น ๆ สำหรับ CUDA
แนวทางนี้สะท้อนทิศทางของ Local AI ที่กำลังให้ความสำคัญกับ low-precision computation มากขึ้น โดยเฉพาะบน GPU รุ่นใหม่ที่มีฮาร์ดแวร์รองรับการคำนวณรูปแบบความละเอียดต่ำโดยตรง อย่างไรก็ตาม การรองรับ kernel ไม่ได้หมายความว่าโมเดล GGUF ทุก quantization จะสามารถใช้เส้นทาง W4A4 ได้ทั้งหมด การเลือก kernel ยังขึ้นอยู่กับ architecture, data type และรูปแบบของโมเดลด้วย
Vulkan ได้ Sparse Flash Attention
หัวข้อที่มีชื่อว่า “Vulkan ได้ Sparse Flash Attention”สำหรับผู้ใช้ GPU ที่ไม่ได้อยู่ใน ecosystem ของ CUDA ก็มีข่าวดีเช่นกัน
v0.6.0 เพิ่ม Sparse Flash Attention สำหรับ quantized K/V บน Vulkan ขณะที่ ggml v0.26.0 ยังเพิ่ม sparse Flash Attention kernels สำหรับ SYCL, Vulkan และ Metal
การเปลี่ยนแปลงนี้มีความสำคัญกับ ecosystem ของ Local AI เพราะ llama.cpp สามารถใช้ backend ที่หลากหลายมากขึ้น โดยไม่จำเป็นต้องผูกติดกับ CUDA เพียงอย่างเดียว
อย่างไรก็ตาม ประสิทธิภาพจริงบน AMD Radeon, Intel GPU หรือ GPU ที่ใช้ Vulkan จะขึ้นอยู่กับ backend, driver, kernel และโมเดลที่กำลังรัน ดังนั้นการเห็นว่ามี kernel รองรับไม่ได้หมายความว่าประสิทธิภาพจะเทียบเท่ากับ CUDA โดยอัตโนมัติ
Metal ได้รับการปรับปรุงสำหรับ Apple Silicon
หัวข้อที่มีชื่อว่า “Metal ได้รับการปรับปรุงสำหรับ Apple Silicon”ฝั่ง Apple ก็ได้รับการปรับปรุงเช่นกัน โดย v0.6.0 เพิ่ม tensor API Flash Attention kernel สำหรับ F16 KV บน Metal
นอกจากนี้ยังมี few-row MMA matmul kernels สำหรับ speculative และ batched decoding ซึ่งโครงการระบุว่าสามารถทำให้ matmul บน Apple GPU เร็วขึ้นได้สูงสุดประมาณ 3 เท่า ใน workload ที่เกี่ยวข้อง
เช่นเดียวกับตัวเลข 1.5× ของ Qwen4Exp ตัวเลข 3× นี้เป็นผลที่โครงการรายงานสำหรับ kernel/workload ที่เกี่ยวข้อง ไม่ใช่ตัวเลขการเพิ่มประสิทธิภาพโดยรวมของ llama.cpp บนทุก Mac
KV Cache และ Multi-GPU ได้รับการแก้ไข
หัวข้อที่มีชื่อว่า “KV Cache และ Multi-GPU ได้รับการแก้ไข”v0.6.0 ยังมีการแก้ไขในส่วนที่เกี่ยวข้องกับ KV Cache หลายรายการ เช่น ปัญหาการ restore KV cache ที่มี rotation ไม่ตรงกัน รวมถึงการ cleanup K/V และ recurrent state หลังจาก restore ไม่สำเร็จ
สำหรับระบบที่ใช้ context ยาวและมีการบันทึกหรือ restore session การแก้ไขเหล่านี้มีความสำคัญ เพราะปัญหาใน KV cache สามารถส่งผลต่อความถูกต้องและเสถียรภาพของ inference ได้
ในส่วนของ Multi-GPU มีการแก้ไข tensor split สำหรับ fused QKV ที่มี K/V head size ไม่เท่ากัน และปรับการจัดการ recurrent state ให้ reserve memory ครอบคลุมทุก split
สิ่งนี้มีความสำคัญมากขึ้นเรื่อย ๆ เนื่องจากโมเดลขนาดใหญ่กำลังเกินขีดจำกัดของ VRAM บน GPU เพียงใบเดียว และผู้ใช้ Local AI จำเป็นต้องกระจายโมเดลไปยัง GPU หลายตัว
Web UI ใหม่ เข้าใกล้การเป็น Local AI Platform มากขึ้น
หัวข้อที่มีชื่อว่า “Web UI ใหม่ เข้าใกล้การเป็น Local AI Platform มากขึ้น”อีกส่วนหนึ่งที่ผู้ใช้ทั่วไปจะเห็นได้ชัดคือ Web UI
llama.cpp v0.6.0 เพิ่มระบบดาวน์โหลดโมเดลใหม่และเชื่อมต่อกับ Hugging Face Hub data layer พร้อมระบบประเมินว่าโมเดลสามารถ fit ลงใน memory ได้หรือไม่ รวมถึงปรับปรุงการจัดการ model ID, quantization และ model capabilities
การเปลี่ยนแปลงนี้ทำให้ llama.cpp ค่อย ๆ ขยับจากการเป็น inference engine ที่เน้น command line ไปสู่เครื่องมือที่ผู้ใช้ทั่วไปสามารถจัดการโมเดลผ่าน Web UI ได้สะดวกขึ้น
สำหรับผู้ที่กำลังทดลอง Local AI โดยไม่ต้องการพึ่ง Ollama หรือระบบ frontend แยกต่างหาก จุดนี้ถือว่าน่าสนใจ
รองรับโมเดลใหม่มากขึ้น
หัวข้อที่มีชื่อว่า “รองรับโมเดลใหม่มากขึ้น”llama.cpp v0.6.0 เพิ่มหรือปรับปรุงการรองรับโมเดลหลายกลุ่ม ได้แก่
- GLM-5.3-Flash / GLM5-Next — โมเดล 320B แบบ hybrid text + vision
- Clef — decision model รองรับทั้ง text และ vision
- Ling 3.0 VL
- Nimble — decision model
- LFM2.5-Encoder — bidirectional masked language model
- รองรับ
classifier_poolingสำหรับ reranker บางประเภท
โดยเฉพาะ GLM-5.3-Flash ซึ่งมีขนาด 320B และใช้ architecture แบบ hybrid แสดงให้เห็นว่า llama.cpp กำลังขยายขอบเขตการรองรับโมเดลที่มี architecture ซับซ้อนมากขึ้นเรื่อย ๆ
เพิ่ม API สำหรับ Decision Models
หัวข้อที่มีชื่อว่า “เพิ่ม API สำหรับ Decision Models”อีกฟีเจอร์ที่อาจไม่ได้เป็นที่สนใจของผู้ใช้ทั่วไป แต่สำคัญในระดับ infrastructure คือ API ใหม่
/v1/systemone
API นี้ถูกออกแบบมาสำหรับ decision models เช่น laya, julia-1, lev, openjev และ kev รวมถึงมีการขยายการรองรับไปยัง Nimble
นอกจากนี้ /v1/embeddings ยังรองรับ typed content ที่เป็น vision, audio และ video และ API สำหรับดูรายการโมเดลสามารถรายงาน modality ของ input/output ผ่าน architecture object ได้ด้วย
สิ่งเหล่านี้ทำให้ llama.cpp มีความสามารถมากกว่าเพียงการรับข้อความแล้วส่งข้อความตอบกลับ และเริ่มมีโครงสร้างที่เหมาะกับระบบ AI ที่มีหลาย modality และหลายประเภทของ model pipeline
ggml v0.26.0 เป็นอีกส่วนสำคัญของการอัปเดต
หัวข้อที่มีชื่อว่า “ggml v0.26.0 เป็นอีกส่วนสำคัญของการอัปเดต”llama.cpp v0.6.0 มาพร้อม ggml v0.26.0 ซึ่งมีการเปลี่ยนแปลงในระดับ backend จำนวนมาก เช่น
- sparse Flash Attention บน SYCL, Vulkan และ Metal
- Lightning Indexer improvements
- BF16 operations บน CPU
- tiled k-quant
mul_mat - CUDA W4A4 สำหรับ NVFP4/MXFP4
- MMVQ shared-expert fusion
- sampler และ quantization types เพิ่มเติมสำหรับ Hexagon
- ปรับปรุง WebGPU, OpenVINO, OpenCL และ SYCL
นอกจากนี้ยังมีการปรับปรุงการโหลดโมเดล โดยเพิ่มการตรวจสอบขนาด GGUF ที่เข้มงวดขึ้น และเปิดใช้งาน Windows ARM64 MSVC builds
สรุป: v0.6.0 ไม่ใช่แค่การเพิ่มโมเดล
หัวข้อที่มีชื่อว่า “สรุป: v0.6.0 ไม่ใช่แค่การเพิ่มโมเดล”llama.cpp v0.6.0 เป็นการอัปเดตที่มีความสำคัญในระดับ architecture มากกว่าการเพิ่มฟีเจอร์ให้ผู้ใช้ทั่วไปเพียงไม่กี่รายการ
หัวใจสำคัญอยู่ที่การพัฒนา llama_batch_ext, MTP, speculative decoding, DFlash และการรองรับโมเดล architecture ใหม่ ขณะเดียวกัน backend อย่าง CUDA, Vulkan และ Metal ก็ได้รับ optimization ที่รองรับแนวทางการประมวลผลแบบ low precision และ attention รุ่นใหม่
อีกด้านหนึ่ง Web UI และระบบจัดการโมเดลที่เชื่อมกับ Hugging Face ก็ทำให้ llama.cpp เข้าใกล้การเป็น Local AI runtime ที่ครบวงจรมากขึ้น
สำหรับผู้ที่ใช้ llama.cpp เป็น runtime หลักในการรันโมเดล GGUF การอัปเดตเป็น v0.6.0 จึงมีเหตุผลมากกว่าการอัปเดตเพื่อให้ได้ฟีเจอร์ใหม่เพียงอย่างเดียว โดยเฉพาะผู้ที่กำลังทดลอง MTP, speculative decoding, DFlash, Multi-GPU หรือโมเดลรุ่นใหม่อย่าง Qwen4Exp
อย่างไรก็ตาม หากต้องการวัดประโยชน์ของ v0.6.0 อย่างจริงจัง ควร benchmark ก่อนและหลังการอัปเดตบน โมเดลและ hardware เดียวกัน เพราะ optimization หลายรายการเป็น model- และ backend-specific ไม่ได้ทำให้ทุก workload เร็วขึ้นในสัดส่วนเดียวกัน
อ้างอิง:
llama.cpp v0.6.0 Release Notes — GitHub
llama.cpp Official Repository