Strata 0.2.11 รองรับ Qwen3.8-Flash-Next จาก Unsloth Dynamic v3.1 ปรับปรุง Multi-GPU, NVIDIA CUDA, AMD Radeon และการจัดการ VRAM พร้อมแก้ไขปัญหาการบันทึก Chat และความเสถียร
Tag: VRAM Budget
- Strata 0.2.11 อัปเดต รองรับ Qwen3.8-Flash-Next รุ่นใหม่จาก Unsloth เพิ่มประสิทธิภาพ Multi-GPU และเร่งความเร็ว Prompt Processing
- คู่มือ VRAM 16GB: โมเดล 12B สบาย แต่ 27B ที่ Q4 ยังไม่พอดีบนการ์ดใบเดียว
คู่มือสำหรับการ์ดจอ VRAM 16GB สรุปความพอดีของโมเดลและ quantization พร้อมผลวัดจริงจากการต่อการ์ด 16GB สองใบ (RX 9060 XT คู่ และ RX 9070 XT + RX 6800 XT)
- คู่มือ VRAM 8GB: รันโมเดลอะไรได้บ้าง
คู่มือสำหรับการ์ดจอ VRAM 8GB สรุปว่าโมเดลขนาดไหนและ quantization ระดับไหนพอดี เหลือที่ให้ context เท่าไร และทางเลือกเมื่อไม่พอ
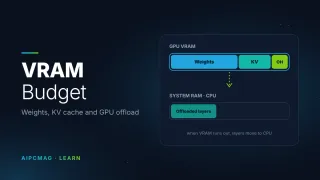
- พื้นที่ VRAM ของการ์ดจอถูกใช้ไปกับอะไรบ้าง และจัดการได้อย่างไรถ้ามีไม่พอ
แนวทางคำนวณงบหน่วยความจำ VRAM จากน้ำหนักโมเดล KV cache และ overhead พร้อมอธิบายการทำ GPU offload และการแบ่งชั้นไป CPU เมื่อหน่วยความจำไม่พอ
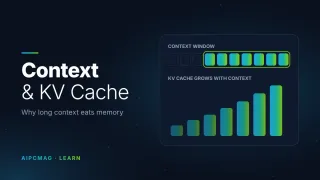
- Context Window และ KV Cache: ทำไมบริบทยาวขึ้นจึงกินหน่วยความจำมากขึ้น
อธิบาย Context Window และ KV Cache ว่าแต่ละอย่างคืออะไร ทำงานร่วมกันอย่างไร และเพราะเหตุใดการเปิดบริบทยาวจึงทำให้ VRAM เพิ่มขึ้นอย่างมีนัยสำคัญ
- รายงานผลการทดสอบ: NVIDIA GeForce RTX 5060 Ti 16GB กับการรัน Local LLM บน Windows — ประชัน CUDA vs Vulkan บน Dense 12B และ MoE 26B
ผลการทดสอบเชิงลึกการ์ดจอ NVIDIA GeForce RTX 5060 Ti 16GB (สถาปัตยกรรม Blackwell) ด้วย PromptMark v0.4.0 เปรียบเทียบรันไทม์ CUDA vs Vulkan บน Gemma-4 12B และทดสอบขีดจำกัดหน่วยความจำบน Gemma-4 26B-A4B MoE ในภาวะ VRAM-Tight
- รายงานผลการทดสอบ: AMD Radeon RX 9070 XT 16GB กับการรัน Local LLM บน Windows — ประชัน ROCm vs Vulkan บน 8 โมเดล LLM พร้อมทดสอบขีดจำกัด Concurrency
ผลการทดสอบเชิงลึกการ์ดจอ AMD Radeon RX 9070 XT 16GB (สถาปัตยกรรม RDNA 4) ด้วย PromptMark v0.4.0 และ Concurrent Text Benchmark เปรียบเทียบรันไทม์ ROCm vs Vulkan ทั้งโมเดล MoE, Dense และฟอร์แมตควอนไทซ์ NVFP4 พร้อมวัดประสิทธิภาพการรองรับผู้ใช้พร้อมกัน 16 ผู้ใช้
- รายงานผลการทดสอบ: Intel Arc B580 Dual GPU (2x 12GB รวม 24GB VRAM) กับการรัน Local LLM บน Windows
ผลการทดสอบเชิงลึกการ์ดจอคู่ Intel Arc B580 24GB VRAM ด้วย PromptMark v0.4.0 เปรียบเทียบรันไทม์ SYCL vs Vulkan และสถาปัตยกรรม MoE vs Dense บน 8 โมเดล LLM ยอดนิยม
- รายงานผลการทดสอบ: Intel Arc B580 12GB กับการรัน Local LLM บน Windows (Vulkan vs SYCL)
ผลการทดสอบการ์ดจอ Intel Arc B580 12GB (สถาปัตยกรรม Xe2) ด้วย PromptMark เปรียบเทียบรันไทม์ Vulkan vs SYCL บน 5 รูปแบบโมเดล LLM พร้อมวิเคราะห์ Prefill, Decode และการสเกล Context 8K
- เครื่องฉันรัน AI ได้ไหม: เช็กเครื่องตัวเองให้ตรงกับงาน Local AI ที่อยากทำ
สเปคเครื่องฉันรัน AI ได้ไหม: คำตอบไม่ได้เริ่มจากสเปค แต่เริ่มจากงานที่อยากทำ เช็กเครื่องตัวเองให้ตรงกับงาน Local AI ที่อยากทำ
- GLM-5.2-GGUF มาแล้ว: โมเดลเปิด 744B ที่รันแบบ Local ได้ แต่ต้องการหน่วยความจำระดับ 200GB ขึ้นไป
Unsloth ปล่อย GLM-5.2-GGUF สำหรับรันโมเดล GLM-5.2 แบบ Local AI ด้วย quantization ระดับ 1-bit ถึง 8-bit แต่ยังต้องใช้ RAM+VRAM หลัก 200GB ขึ้นไป ไม่ใช่โมเดลสำหรับคอมพิวเตอร์ทั่วไป