MoE vs Dense: ทำไมโมเดล 35B ถึงตอบเร็วเหมือนโมเดล 3B
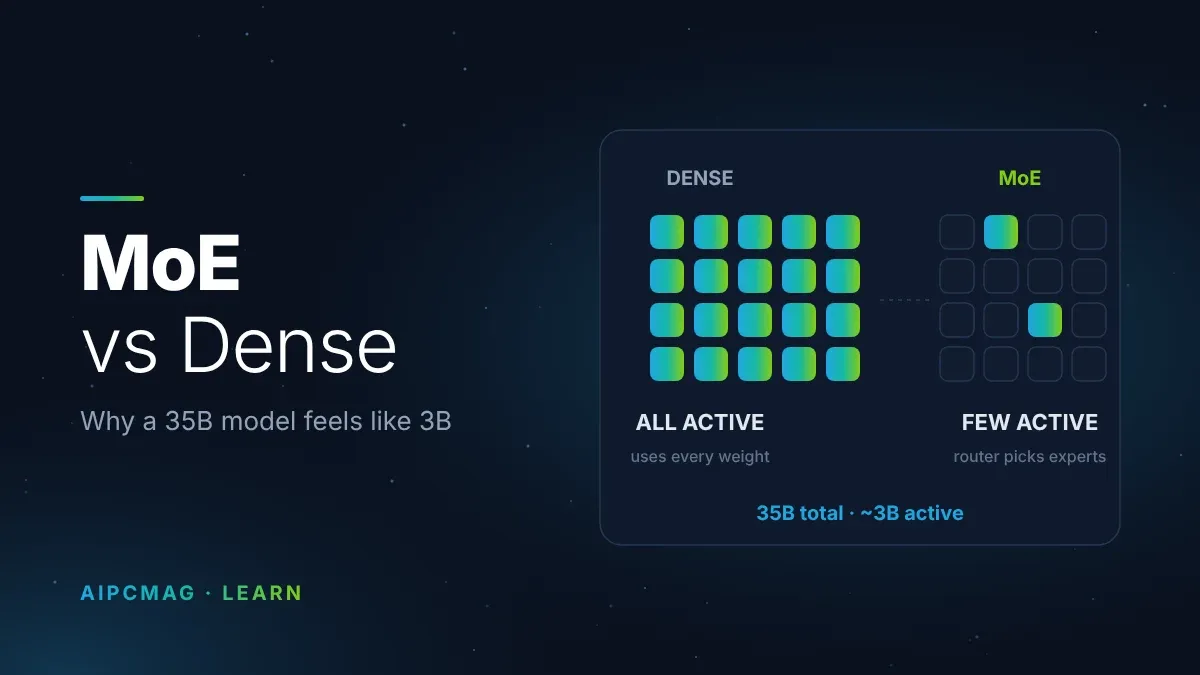
ถ้าคุณเคยเห็นชื่อโมเดลอย่าง Qwen3.6-35B-A3B แล้วสงสัยว่ามันคือโมเดล 35B หรือ 3B กันแน่ คำตอบคือมีพารามิเตอร์รวม 35 พันล้านตัว แต่มีเพียงราว 3 พันล้านตัวที่ทำงานในการสร้างโทเคนแต่ละครั้ง นี่คือความต่างระหว่างโมเดลแบบ Dense และ Mixture-of-Experts (MoE)
Dense โมเดลคืออะไร
หัวข้อที่มีชื่อว่า “Dense โมเดลคืออะไร”โมเดลแบบ Dense คือโมเดลแบบดั้งเดิม ที่ใช้พารามิเตอร์ทุกตัวกับทุกโทเคนเสมอ พารามิเตอร์รวมจึงเท่ากับพารามิเตอร์ที่ทำงานจริง
ข้อดีคือเรียบง่าย ทำนายพฤติกรรมได้ตรงไปตรงมา และปรับแต่งได้คาดเดาง่าย ข้อเสียคือเมื่อจะเพิ่มความสามารถ ต้องเพิ่มพารามิเตอร์ทั้งหมด ซึ่งทำให้ทั้งเวลาและหน่วยความจำเพิ่มตาม
MoE คืออะไร
หัวข้อที่มีชื่อว่า “MoE คืออะไร”โมเดลแบบ Mixture-of-Experts แบ่งชั้น feed-forward ออกเป็น “ผู้เชี่ยวชาญ” (experts) หลายชุด และมีตัวจัดเส้นทาง (router) เลือกใช้เพียงไม่กี่ expert ต่อโทเคน
ผลคือ:
- พารามิเตอร์รวม (total parameters) สูง เพราะมี experts หลายชุด แต่ละชุดมีความรู้เฉพาะทาง
- พารามิเตอร์ที่ทำงานจริง (active parameters) ต่ำ เพราะแต่ละโทเคนผ่านเพียงไม่กี่ expert
แนวคิดนี้มาจากงานอย่าง Switch Transformer และพิสูจน์ในวงกว้างกับ Mixtral ซึ่งเปิดให้ใช้ทั่วไป arxiv
อ่านรหัส A3B, A4B ในชื่อโมเดล
หัวข้อที่มีชื่อว่า “อ่านรหัส A3B, A4B ในชื่อโมเดล”ตัวอักษร A ในชื่อโมเดลคือ active parameters
| ชื่อโมเดล | พารามิเตอร์รวม | ที่ทำงานจริงต่อโทเคน |
|---|---|---|
| qwen3-6-35b-a3b | ~35B | ~3B |
| nemotron-3-5-lightning-30b-a3b | ~30B | ~3B |
| gemma-4-26b-a4b-it | ~26B | ~4B |
ส่วนโมเดลที่ไม่มร A กำกับ มักเป็นแบบ Dense เช่น qwen3-8-27b ที่พารามิเตอร์ทั้ง 27B ทำงานทุกโทเคน
ทำไม MoE ถึงเร็วเหมือนโมเดลเล็ก
หัวข้อที่มีชื่อว่า “ทำไม MoE ถึงเร็วเหมือนโมเดลเล็ก”จากที่อธิบายใน Prefill vs Decode: TTFT และ TPS ระยะ decode ถูกจำกัดด้วยแบนด์วิดท์หน่วยความจำ และปริมาณข้อมูลที่ต้องอ่านต่อโทเคนขึ้นกับ พารามิเตอร์ที่ทำงานจริง
โมเดล MoE ที่ active 3B จึงอ่านข้อมูลต่อโทเคนพอ ๆ กับโมเดล dense 3B แม้ความรู้รวมจะใกล้โมเดล 35B นี่คือเหตุผลที่ MoE ให้ความเร็วสูงโดยที่คุณภาพยังได้เปรียบ
ราคาที่ต้องจ่าย: หน่วยความจำ
หัวข้อที่มีชื่อว่า “ราคาที่ต้องจ่าย: หน่วยความจำ”จุดที่ต้องระวังคือ หน่วยความจำต้องโหลด expert ทั้งหมด ไม่ใช่แค่ส่วนที่ทำงาน ในแต่ละโทเคน router อาจเลือก expert คนละชุด จึงต้องมีทุกชุดพร้อมใช้
หมายความว่าโมเดล MoE 35B-A3B:
- เร็ว เหมือนโมเดลเล็ก (เพราะ active น้อย)
- แต่ กินหน่วยความจำ ตามขนาดรวม (เพราะต้องเก็บ expert ทั้งหมด)
ดังนั้นเวลาใช้ VRAM ตาม VRAM ที่มี และการตั้งค่า GPU Offload ให้คำนวณจาก พารามิเตอร์รวม ไม่ใช่ active
เปรียบเทียบสั้น ๆ
หัวข้อที่มีชื่อว่า “เปรียบเทียบสั้น ๆ”| หัวข้อ | Dense | MoE |
|---|---|---|
| พารามิเตอร์ทำงาน | ทั้งหมด | เฉพาะ expert ที่ถูกเลือก |
| ความเร็วต่อโทเคน | ตามขนาดรวม | ตาม active เป็นหลัก |
| หน่วยความจำ | ตามขนาดรวม | ตามขนาดรวม |
| ความรู้ต่อขนาด | - | สูงกว่าที่ active บ่งชี้ |
| ความซับซ้อน | ต่ำ | สูงขึ้น มี router และ overhead |
MoE ไม่ได้เสกความเร็วขึ้นมาจากอากาศ แต่ย้ายภาระจาก compute และแบนด์วิดท์ต่อโทเคนไปเป็นหน่วยความจำรวมแทน คุณจึงควรถามสองคำถามแยกกันเสมอ:
- VRAM/RAM พอไหม ดูจากพารามิเตอร์รวม
- เร็วพอไหม ดูจาก active parameters
เมื่อแยกสองคำถามนี้ได้ การเลือกโมเดล MoE หรือ Dense ให้เหมาะกับเครื่องคุณจะชัดเจนขึ้นมาก