Microsoft เผยวิธีบีบโมเดลเขียนโค้ด MAI-Code-1.1-Flash จากประมาณ 276 GB เหลือ 53.0 GiB พร้อม speculative decoding และผลวัดบน RTX Spark 128GB (ผลวัดของ Microsoft ไม่ใช่ผลทดสอบของเรา)
Tag: bpw (bits per weight)
- MAI-Code-1.1-Flash: โมเดล MoE 137.9B บีบเหลือ 53 GB รันบน Windows ด้วย RTX Spark
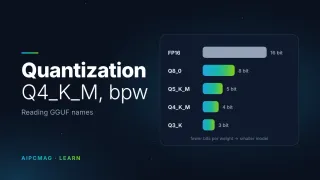
- ถอดรหัสโมเดล Q4_K_M, Q3_K_XL หมายถึงอะไร
อธิบาย Quantization ของโมเดล Local AI ผ่านชื่อ GGUF อย่าง Q4_K_M, Q5_K_M และ Q8_0 ว่าแต่ละส่วนหมายถึงอะไร พร้อมแนวคิด bpw ที่ใช้คำนวณขนาดและหน่วยความจำ
- bpw (Bits per Weight)
จำนวนบิตเฉลี่ยที่ใช้เก็บ weight หนึ่งตัวในไฟล์โมเดล ยิ่งต่ำไฟล์ยิ่งเล็ก
- Quantization
การลดความละเอียดของตัวเลข weights ในโมเดล (เช่น จาก 16-bit เหลือ 4-bit) เพื่อให้ไฟล์เล็กลงและใช้ RAM/VRAM น้อยลง โดยแลกกับคุณภาพที่อาจลดลง