รายงานผลการทดสอบ: Dual AMD Radeon RX 9060 XT 16GB (รวม 32GB VRAM) กับการก้าวกระโดดของ AMD ROCm 10 Native RDNA 4
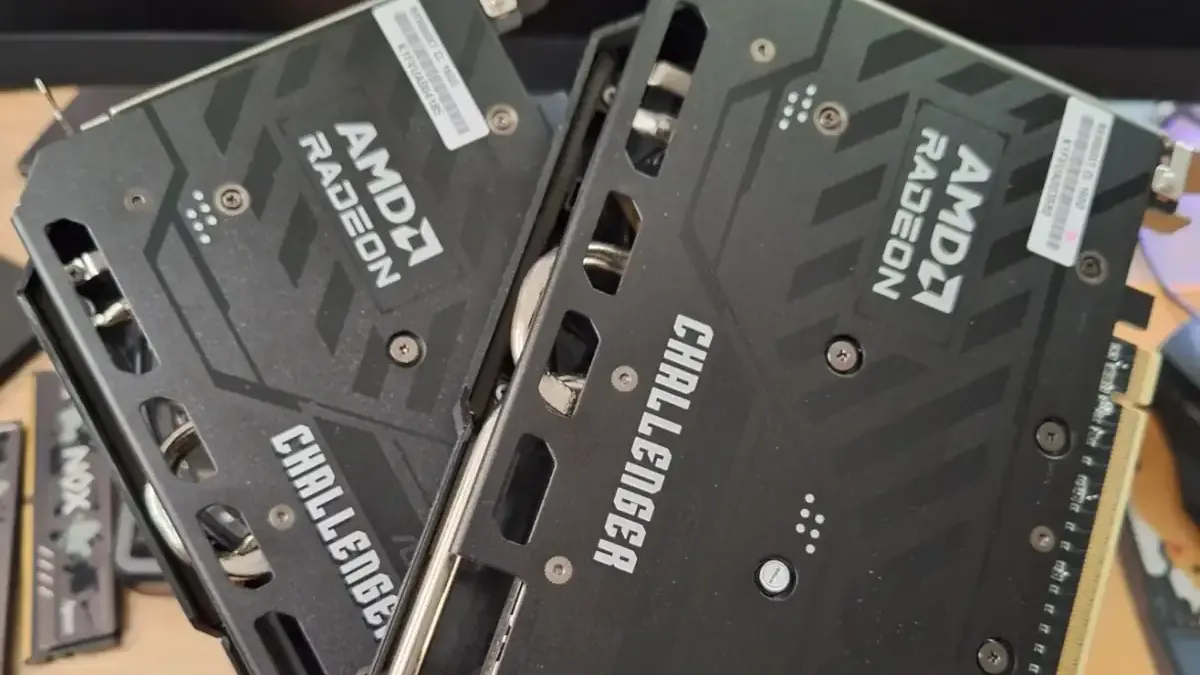
การรันโมเดลภาษาขนาดใหญ่ (LLM) ในระดับ Local Workstation ปัจจัยสำคัญที่สุดไม่ได้ขึ้นอยู่กับพลังการประมวลผลดิบของฮาร์ดแวร์เพียงอย่างเดียว แต่ยังขึ้นอยู่กับ ขนาด VRAM และ ความสมบูรณ์ของชุดซอฟต์แวร์ที่รองรับอีกด้วย
บทความนี้สรุปผลการทดสอบเชิงลึกของกราฟิกการ์ดสถาปัตยกรรมรุ่นใหม่ล่าสุด AMD Radeon RX 9060 XT (RDNA 4) ในรูปแบบ Dual GPU (2× 16GB รวม 32GB VRAM) โดยเปรียบเทียบระหว่าง ROCm 7.14 กับ ROCm 10.0 Native ผ่านชุดทดสอบ PromptMark v0.4.0 บน 6 เวิร์กโหลดการใช้งานจริง
ไฮไลท์และผลการทดสอบสำคัญ
หัวข้อที่มีชื่อว่า “ไฮไลท์และผลการทดสอบสำคัญ”- ROCm 10 ปลดล็อกประสิทธิภาพ Native RDNA 4: ตัวรันไทม์ ROCm 10.0 ที่คอมไพล์เจาะจงสถาปัตยกรรม
gfx1200ให้ความเร็วการสร้างคำตอบ (Decode Speed) บนโมเดล Dense อย่าง Qwen3.8-27B สูงขึ้น +3.3% ถึง +3.5% ในทุกเวิร์กโหลด - Qwen3.6-35B-A3B พลังความเร็วระดับ 54+ Tokens/s: ด้วยการจัดสรรเลเยอร์บน VRAM 32GB โมเดล MoE ขนาด 35B สามารถทำความเร็ว Decode สูงถึง 54.88 tokens/s (อ่าน/ตอบได้ทันทีโดยไม่มีอาการหน่วง) และทำความเร็ว Prefill (อ่าน Prompt) พุ่งแตะ 2,203.4 tokens/s
- การรองรับเอกสารขนาดยาว (Long Context 8K): ในโหมดสรุปเอกสาร 8,192 โทเคน ระบบ Dual RX 9060 XT ใช้เวลาประมวลผลคำแรก (Time-to-First-Token หรือ TTFT) เพียง ~3.78 วินาที สำหรับโมเดล 35B
- ความคุ้มค่าของการต่อ Dual GPU (Layer Split): การรวม VRAM 16GB + 16GB เป็น 32GB ทำให้สามารถโหลดโมเดลระดับ 27B และ 35B ลงบนการ์ดจอได้ 100% (
gpu-layers 999) โดยไม่ต้องดึง RAM เครื่องมาแชร์ให้เกิดคอขวด
ข้อมูลระบบและสภาพแวดล้อมการทดสอบ
หัวข้อที่มีชื่อว่า “ข้อมูลระบบและสภาพแวดล้อมการทดสอบ”| รายการ | รายละเอียดการตั้งค่า |
|---|---|
| GPU Setup | 2× AMD Radeon RX 9060 XT (VRAM รวม 32,608 MiB / GDDR6) |
| GPU Architecture | RDNA 4 (gfx1200), เชื่อมต่อแบบ PCIe 5.0 x8 ต่อใบ |
| ระบบปฏิบัติการ | Windows 11 Pro 64-bit |
| เครื่องมือทดสอบ | PromptMark v0.4.0 (รัน 6 เวิร์กโหลดมาตรฐาน) |
| นโยบาย Cache | ปิด Fresh Prompt Cache (--no-cache-prompt) เพื่อวัดพลังคำนวณจริงของฮาร์ดแวร์ทุกๆ รอบ |
| การแบ่งภาระงาน | --device "ROCm0,ROCm1" --split-mode layer --tensor-split "1,1" --gpu-layers 999 |
| Context Window | 12,288 Tokens |
| ระเบียบวิธีวัดผล | 1 Warm-up Run + 5 Measured Runs แบบ Round-Robin หาค่ามัธยฐาน (Median) |
| ROCm 7 Stack | llama.cpp build 10370 (ROCm 7.14) |
| ROCm 10 Stack | llama.cpp build 10362-rocm10 (AMD ROCm 10.0 Native RDNA 4 Clang Toolchain) |
โมเดลที่นำมาทดสอบ
หัวข้อที่มีชื่อว่า “โมเดลที่นำมาทดสอบ”Qwen3.6-35B-A3B-Q4_K_M(~20.5 GB): โมเดลสถาปัตยกรรม Attention-to-Batch MoE ผสานจุดเด่นด้านการประหยัดพลังคำนวณและความฉลาดของพารามิเตอร์ 35BQwen3.8-27B-Q4_K_M(~16.8 GB): โมเดลสถาปัตยกรรม Dense 27B ที่ต้องคำนวณทุก Layer เต็มรูปแบบ เหมาะสำหรับการวัดพลังการคำนวณดิบ
ผลการทดสอบเปรียบเทียบ
หัวข้อที่มีชื่อว่า “ผลการทดสอบเปรียบเทียบ”1. โมเดล Qwen3.6-35B-A3B (MoE Architecture - 35B)
หัวข้อที่มีชื่อว่า “1. โมเดล Qwen3.6-35B-A3B (MoE Architecture - 35B)”โมเดลนี้เน้นงานประมวลผลที่ต้องการความเร็วสูงและบริบทกว้าง
| เวิร์กโหลด (Workload) | ขนาด Prompt/Output | ROCm 7 Decode (tok/s) | ROCm 10 Decode (tok/s) | Decode Speedup | ROCm 7 Prefill (tok/s) | ROCm 10 Prefill (tok/s) | Prefill Speedup | TTFT ROCm 10 (วินาที) |
|---|---|---|---|---|---|---|---|---|
| Content Generation | 512/256 | 54.33 | 54.88 | +1.03% | 1,169.4 | 1,184.6 | +1.30% | 0.529s (เร็วขึ้น 7.8%) |
| Creative Writing | 512/512 | 54.14 | 54.78 | +1.18% | 1,166.4 | 1,174.1 | +0.66% | 0.553s |
| Summarization Light (2K) | 2048/256 | 53.96 | 54.58 | +1.14% | 1,721.8 | 1,738.4 | +0.96% | 1.249s |
| Summarization Moderate (4K) | 4096/ 256 | 53.56 | 54.16 | +1.12% | 2,070.1 | 2,077.6 | +0.37% | 2.076s |
| Summarization Long (8K) | 8192/ 256 | 52.76 | 53.37 | +1.14% | 2,196.2 | 2,203.4 | +0.33% | 3.781s |
| Code Analysis (4K) | 4096/ 256 | 53.53 | 54.20 | +1.25% | 2,039.6 | 2,053.1 | +0.66% | 2.163s |
ข้อสังเกต: โมเดล Qwen3.6-35B-A3B รักษาความเร็ว Decode ได้นิ่งมากในทุกความยาวบริบท ตั้งแต่ 512 โทเคนไปจนถึง 8K โทเคน (54.88/53.37 tok/s) ความเร็วแทบไม่ตกลงเลย และอัตรา Prefill ทะลุ 2,200 tok/s ในบริบท 8K
2. โมเดล Qwen3.8-27B (Dense Architecture - 27B)
หัวข้อที่มีชื่อว่า “2. โมเดล Qwen3.8-27B (Dense Architecture - 27B)”โมเดล Dense แท้ขนาด 27 พันล้านพารามิเตอร์ ซึ่งเป็นตัวชี้วัดการคำนวณ Matrix Multiplication (GEMM) อย่างแท้จริง
| เวิร์กโหลด (Workload) | ขนาด Prompt/Output | ROCm 7 Decode (tok/s) | ROCm 10 Decode (tok/s) | Decode Speedup | ROCm 7 Prefill (tok/s) | ROCm 10 Prefill (tok/s) | Prefill Speedup | เวลารวมตอบ E2E (วินาที) |
|---|---|---|---|---|---|---|---|---|
| Content Generation | 512/ 256 | 14.92 | 15.44 | +3.47% | 464.4 | 469.4 | +1.07% | 17.86s (ลดลง 3.5%) |
| Creative Writing | 512/ 512 | 14.91 | 15.40 | +3.29% | 467.4 | 470.1 | +0.57% | 34.47s (ลดลง 3.1%) |
| Summarization Light (2K) | 2048/ 256 | 14.87 | 15.38 | +3.44% | 697.9 | 702.0 | +0.58% | 19.66s (ลดลง 2.8%) |
| Summarization Moderate (4K) | 4096/256 | 14.76 | 15.27 | +3.47% | 833.0 | 837.0 | +0.47% | 21.68s (ลดลง 2.7%) |
| Summarization Long (8K) | 8192/ 256 | 14.62 | 15.10 | +3.30% | 884.9 | 888.2 | +0.37% | 26.19s (ลดลง 2.3%) |
| Code Analysis (4K) | 4096/ 256 | 14.79 | 15.26 | +3.23% | 833.8 | 837.5 | +0.45% | 22.02s (ลดลง 2.5%) |
ข้อสังเกต: โมเดล Dense 27B เห็นผลต่างของไดรเวอร์ชัดเจนมาก โดย ROCm 10 เร็วกว่า ROCm 7 สม่ำเสมอที่ราว +3.3% ถึง +3.5% ทำให้ดันความเร็วทะลุเพดาน 15 tokens/s ได้ในทุกสถานการณ์
การวิเคราะห์เชิงลึกทางสถาปัตยกรรม
หัวข้อที่มีชื่อว่า “การวิเคราะห์เชิงลึกทางสถาปัตยกรรม ”1. การปรับแต่ง Instruction & MMA บน RDNA 4 (gfx1200)
หัวข้อที่มีชื่อว่า “1. การปรับแต่ง Instruction & MMA บน RDNA 4 (gfx1200)”- ใน ROCm 7 การรองรับชิป RDNA 4 ยังอยู่ในช่วงพัฒนาเบื้องต้น แต่ใน ROCm 10 Native RDNA 4 (build 10362) มีการปรับแต่งชุดคำสั่ง Matrix-Multiply-Accumulate (MMA) และ Vector Instructions ผ่าน LLVM Clang ให้แมปตรงกับหน่วยประมวลผลของ
gfx1200 - การคำนวณของโมเดลแบบ Dense (Qwen3.8-27B) ซึ่งผูกติดกับ Memory Bandwidth และ Tensor Core Operations ได้รับประโยชน์สูงสุด จึงเห็นการเร่งความเร็วอย่างสม่ำเสมอถึง ~3.5%
2. ศักยภาพการประมวลผลบริบทขนาดยาว (Long Context Scaling)
หัวข้อที่มีชื่อว่า “2. ศักยภาพการประมวลผลบริบทขนาดยาว (Long Context Scaling)”- ในงานประเภทวิเคราะห์โค้ดและสรุปเอกสาร (Code Analysis & Summarization 4K-8K) อัตราความเร็วในการอ่าน Prompt (Prefill) ปรับตัวสูงขึ้นตามจำนวนโทเคน:
- จาก 1,184 tok/s (512 tokens) ขยับขึ้นเป็น 1,738 tok/s (2K), 2,077 tok/s (4K) และแตะจุดสูงสุดที่ 2,203 tok/s (8K)
- พฤติกรรมนี้ชี้ว่าชิป RDNA 4 มี Bandwidth กว้างพอที่จะรัน GEMM ขนาดใหญ่ได้อย่างเต็มประสิทธิภาพ ยิ่งอินพุตยาว ยิ่งดึงพลัง GPU ออกมาได้คุ้มค่า
3. ประสิทธิภาพ Multi-GPU สเกลแบบ Dual Card
หัวข้อที่มีชื่อว่า “3. ประสิทธิภาพ Multi-GPU สเกลแบบ Dual Card”- การแบ่งโหลดแบบ Layer Split (
--split-mode layer --tensor-split 1,1) ส่งผ่านข้อมูลข้ามสล็อต PCIe 4.0 x16 ได้อย่างไร้รอยต่อ โดยตลอดการทดสอบโมเดล Qwen3.6-35B มีความเสถียร 100% (ผ่านครบ 5/5 รอบทุกเวิร์กโหลด)
สรุปและคำแนะนำสำหรับการนำไปใช้งาน
หัวข้อที่มีชื่อว่า “สรุปและคำแนะนำสำหรับการนำไปใช้งาน”- สำหรับผู้ใช้ที่ต้องการจัดชุด Local AI Workstation:
- การจับคู่ Dual AMD Radeon RX 9060 XT 16GB (รวม 32GB VRAM) ถือเป็นตัวเลือกที่คุ้มค่ามากสำหรับการรันโมเดลขนาดใหญ่ 27B ถึง 35B ในระดับ Quantization Q4_K_M แบบ Fully Offloaded ไม่ต้องพึ่งพาระบบ Offload ไป CPU RAM
- ความเร็วที่ตอบโจทย์งานจริง:
- หากต้องการ ความเร็วสูงระดับสนทนาสด / Agentic Chatbot แนะนำโมเดลแบบ MoE เช่น Qwen3.6-35B-A3B ซึ่งทำความเร็วแตะ 54-55 tokens/s ได้อย่างสบายตา
- หากต้องการ งานคิดวิเคราะห์ ตรวจสอบโค้ด หรือเอกสารซับซ้อน แนะนำโมเดล Dense เช่น Qwen3.8-27B ที่ความเร็ว 15.1 - 15.4 tokens/s ซึ่งเป็นความเร็วที่อ่านตามได้ทันและให้เหตุผลได้แม่นยำ
- คำแนะนำด้านซอฟต์แวร์:
- แนะนำอย่างยิ่งให้อัปเกรดไปใช้ ROCm 10 Native ขึ้นไป เนื่องจากให้ทั้งความเร็วในการประมวลผลที่เหนือกว่า ROCm 7 เดิม และลด Latency ในการตอบสนองคำแรก (TTFT) ลงอย่างเห็นได้ชัด